Loading content… / 正在加载内容…


NVIDIA 于 2024 年 3 月 19 日推出了 Blackwell 架构 GPU,其中最引人注目的是 B200、B100 和 GB200 GPU,以及 GB200-NVL72 和 GB200-SuperPod。 我们已经对GB200的互连架构进行了深入分析,参考 NVIDIA GB200 互连架构分析 - NVLink、InfiniBand 和未来趋势。
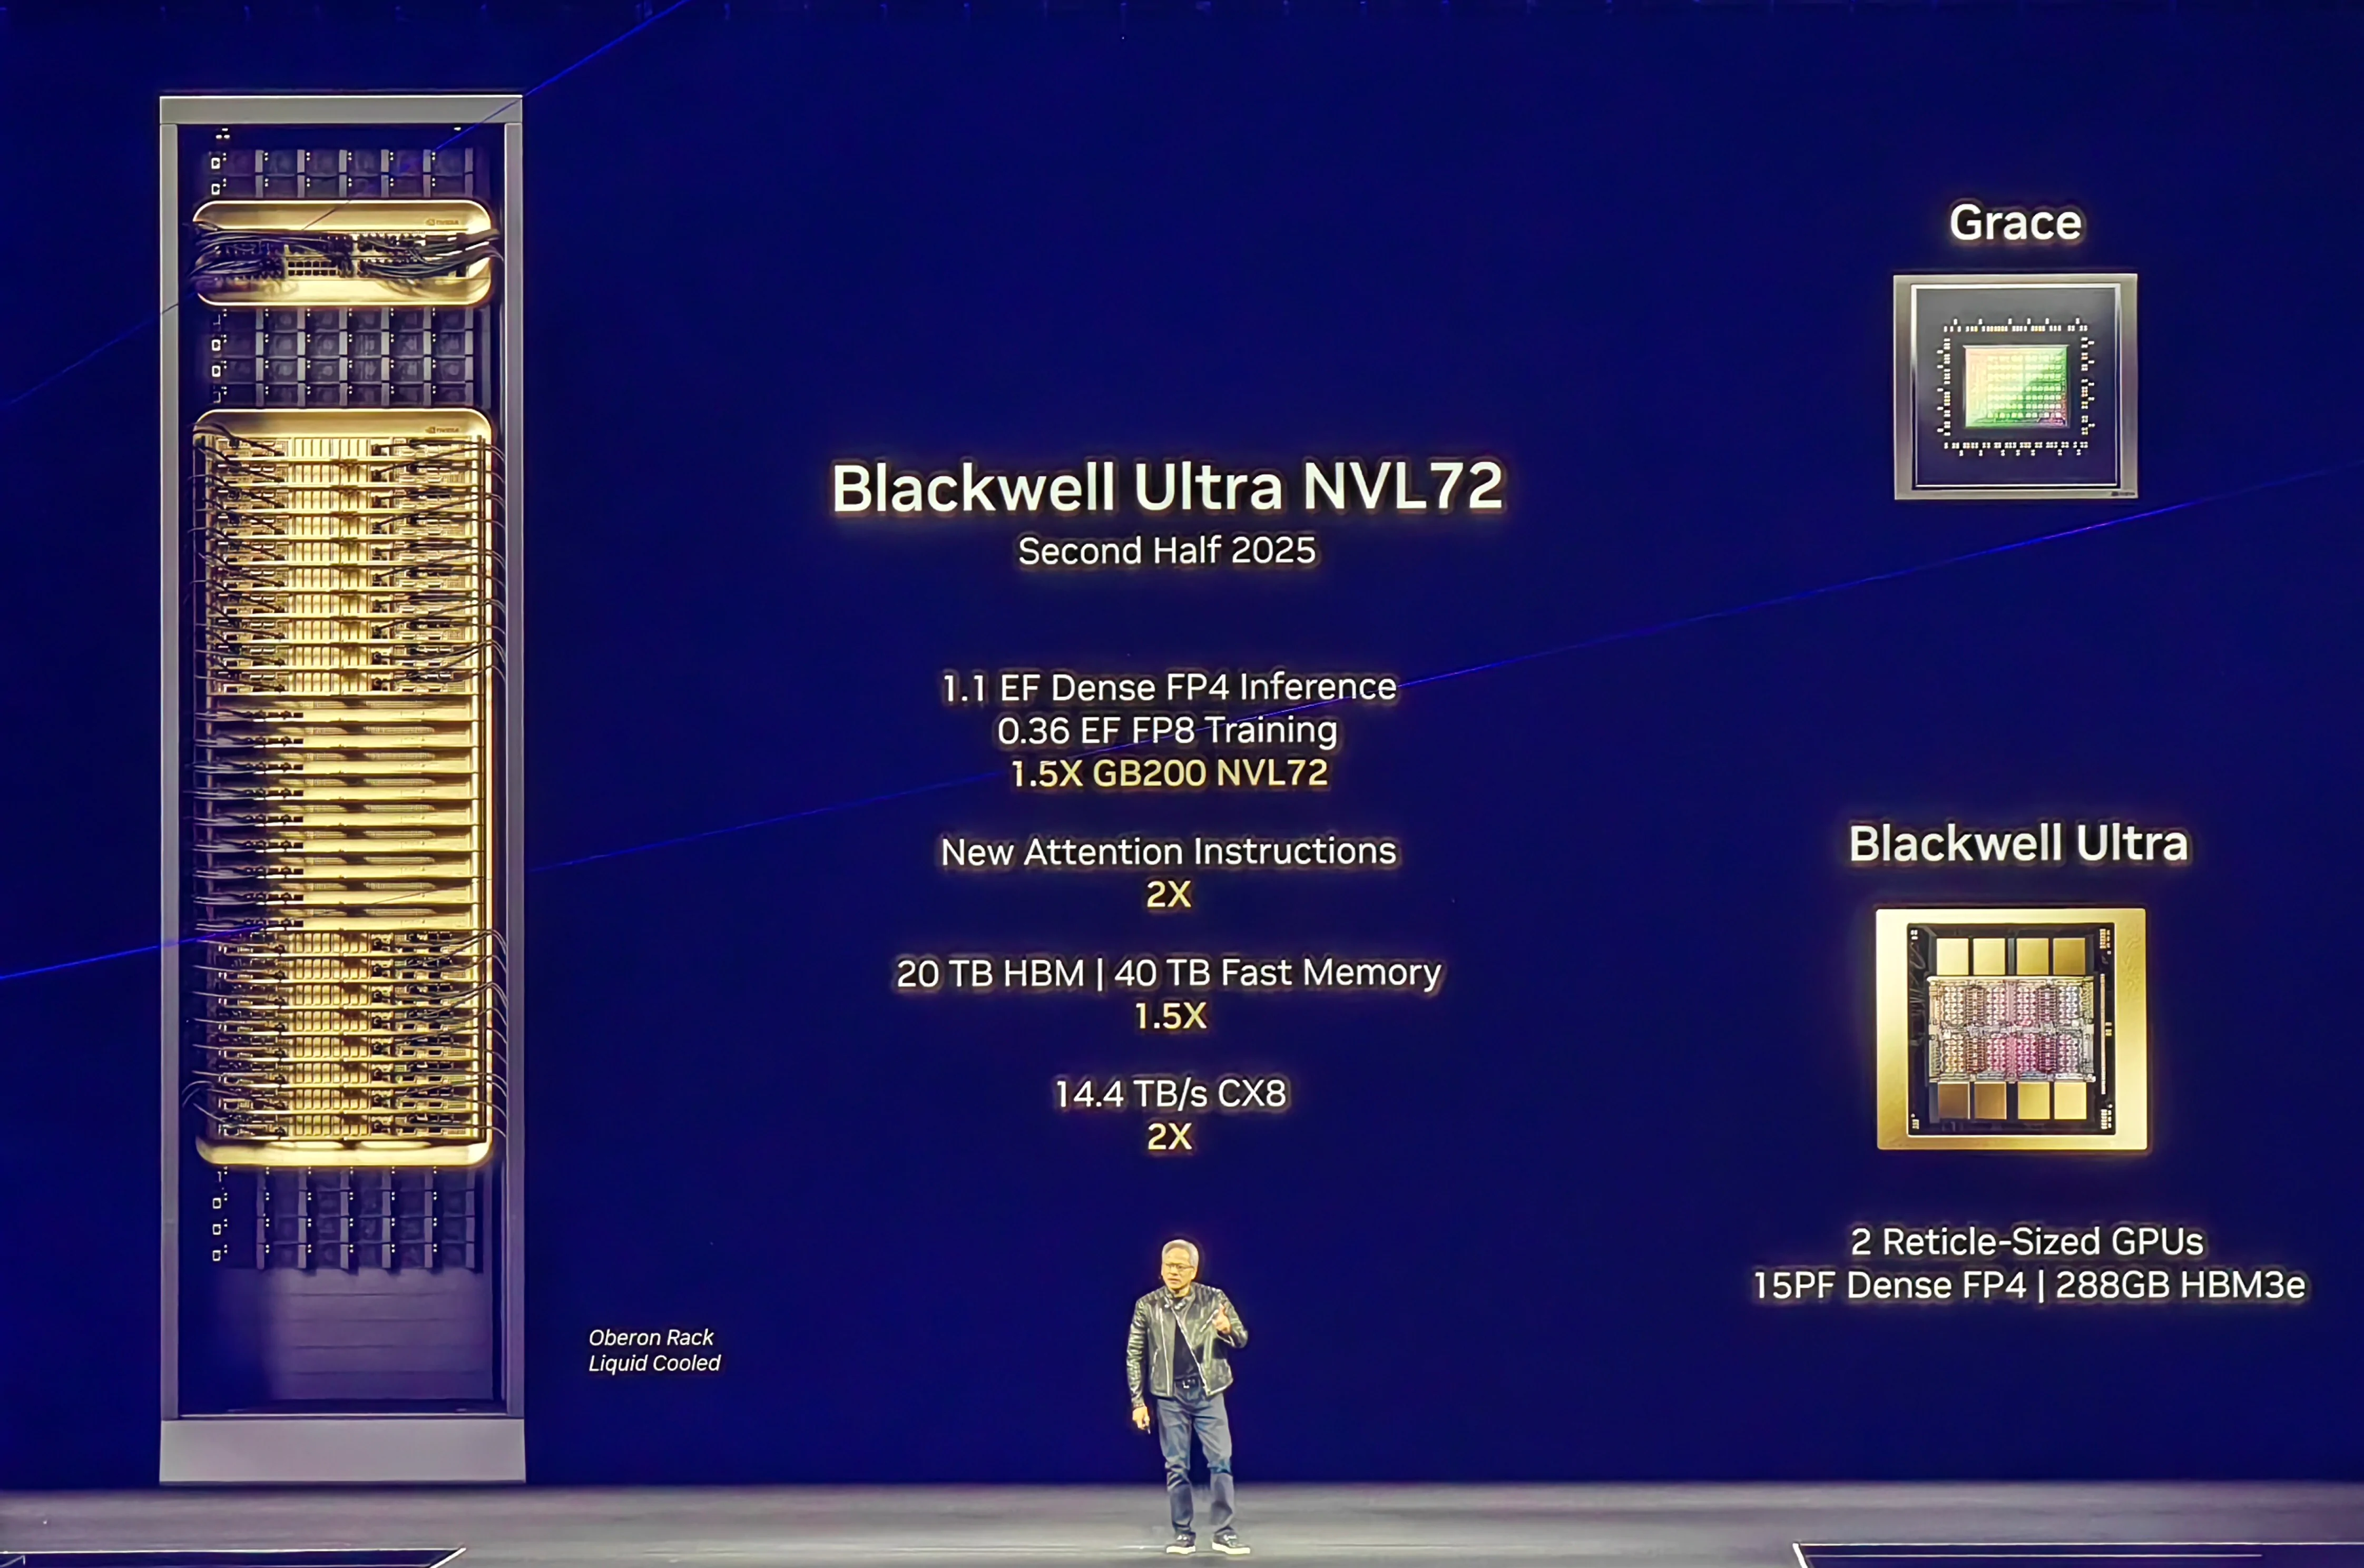
今年3月19日, 2025年全球技术大会,NVIDIA宣布升级B300和GB300 GPU,并对应 DGX B300 和 GB300-NVL72 系统。本文全面介绍了 GB300 的最新进展,与 GB200 进行了并列比较,并重点介绍了推动这一技术飞跃的关键创新和未来趋势。
GB300 全方位升级
1.算力提升
GB300 的单卡 4 位浮点 (FP4) 性能是 GB200 的 1.5 倍。这可以加快复杂人工智能工作负载的计算速度,显著提高生产力并节省数据中心的大量时间成本。
2. 内存容量升级
GB300的内存容量有了重大飞跃,采用12层堆叠HBM3E内存,容量从GB200的192GB提升到288GB。这种扩展的内存使人工智能模型能够处理更大的数据集,从而能够更有效地训练和推理大规模深度学习模型,从而加速各行业的人工智能进步。
3. 网络能力增强
GB300将其网络适配器从 连接X-7 to 连接X-8,而其光模块则从800G跃升至1.6T。这一改进极大地提高了数据传输速度和网络带宽,使服务器能够以更高的效率处理大规模分布式计算任务。减少网络延迟和优化数据交换进一步提升整体系统性能。
4、耗电量增加
GB300的运行功率为1.4kW,比GB200的功率有所增加。 GB200 和 B200 的 TDP(热设计功率)分别为 1.2kW 和 1kW,而 GB300 和 B300 将这些数字提高到 1.4kW 和 1.2kW。这种功率提升可以释放更高的性能,但也需要更先进的冷却解决方案来管理增加的热负荷。
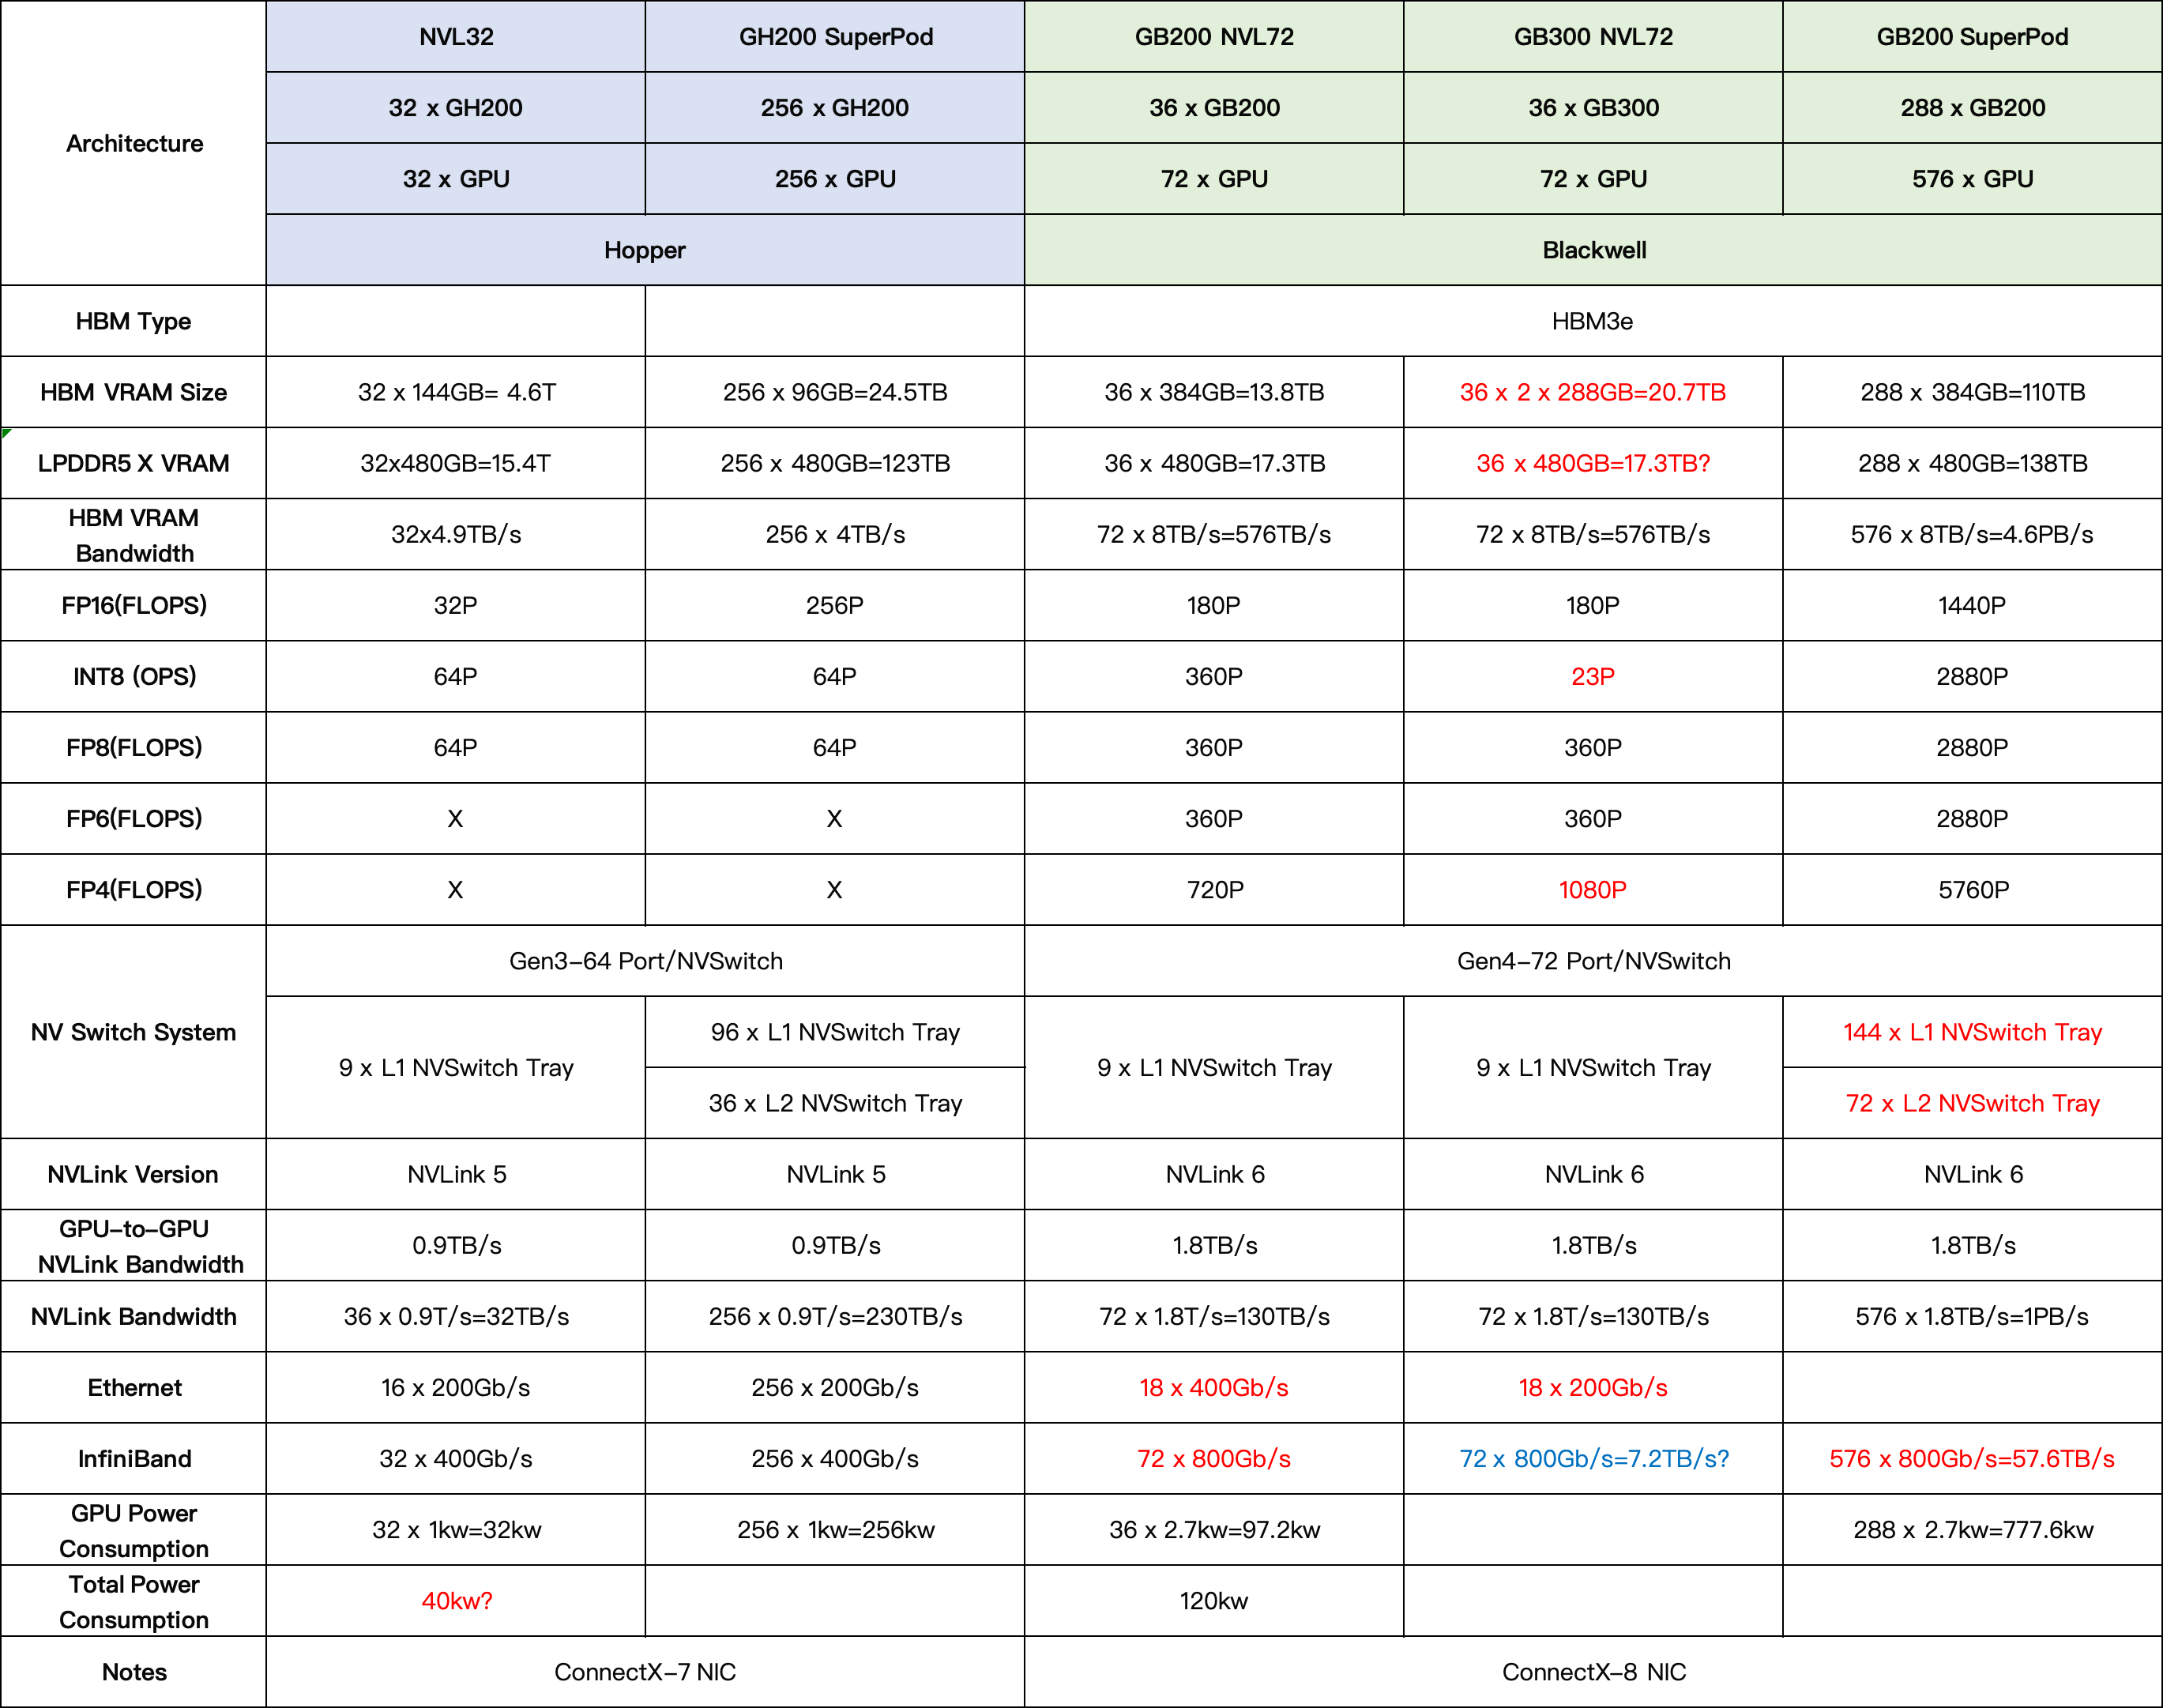
GB300 NVL72 VS GB200 NVL72
如下图所示,GB200 NVL72与GB300 NVL72的主要区别包括:
密集 FP4 计算提升至 1.5 倍:GB200 的密集 FP4 计算为 720P(1440P 时稀疏 FP4 计算的 50%),而 GB300 的密集 FP4 计算跃升至 1080P(1440P 时稀疏 FP4 计算的 75%)。
INT8 计算几乎被淘汰:GB200 提供 360P INT8 稀疏计算,而 GB300 则降至仅 23P INT8 密集计算。
其他计算指标:FP8、FP16/BF16 和 TF32 性能保持相同。 FP64 计算也被削减,尽管其有限的用例减轻了实际影响。
HBM 内存(容量 1.5 倍,带宽保持为每个 GPU 8 TB/s):
- GB200:72 个 GPU × 192GB = 总计 13.8TB。
- GB300:72 个 GPU × 288GB = 总计 20.7TB。
LPDDR5X 内存:细微变化。
- GB200:36 × 480GB = 总计 17.3TB,18.4TB/s 带宽。
- GB300:总计 18TB,带宽 14.3TB/s。
GB300 液冷革命
GB300 的强大性能伴随着巨大的功率需求。随着单GPU TDP飙升至1,400W,全机架系统功耗达到惊人的125-130kW,NVIDIA采用全液冷散热解决方案来应对这一挑战——显著推进液冷技术。
虽然 GB300 保留了 GB200 的歧管、冷却分配单元 (CDU) 和墨盒等组件的设计,但其核心冷却模块经过了重新设计,以实现效率方面的突破。
1. 独立液冷板设计
GB300放弃了GB200的大面积冷板方式,而是为每个GPU芯片配备了专用的进出液冷板。这种设计显著提高了冷却效率,同时实现了更灵活的硬件配置。例如,在 NVL72 系统中,每个计算托盘容纳 6 个 GPU,每个 GPU 需要两对快速连接器(一个入口,一个出口),每个托盘总共 12 对。添加两个用于歧管连接的联轴器使每个托盘的总数达到 14 对。在系统的 18 个计算托盘中,耦合器数量达到惊人的 252 对,是 GB200 的 108 对的两倍多。
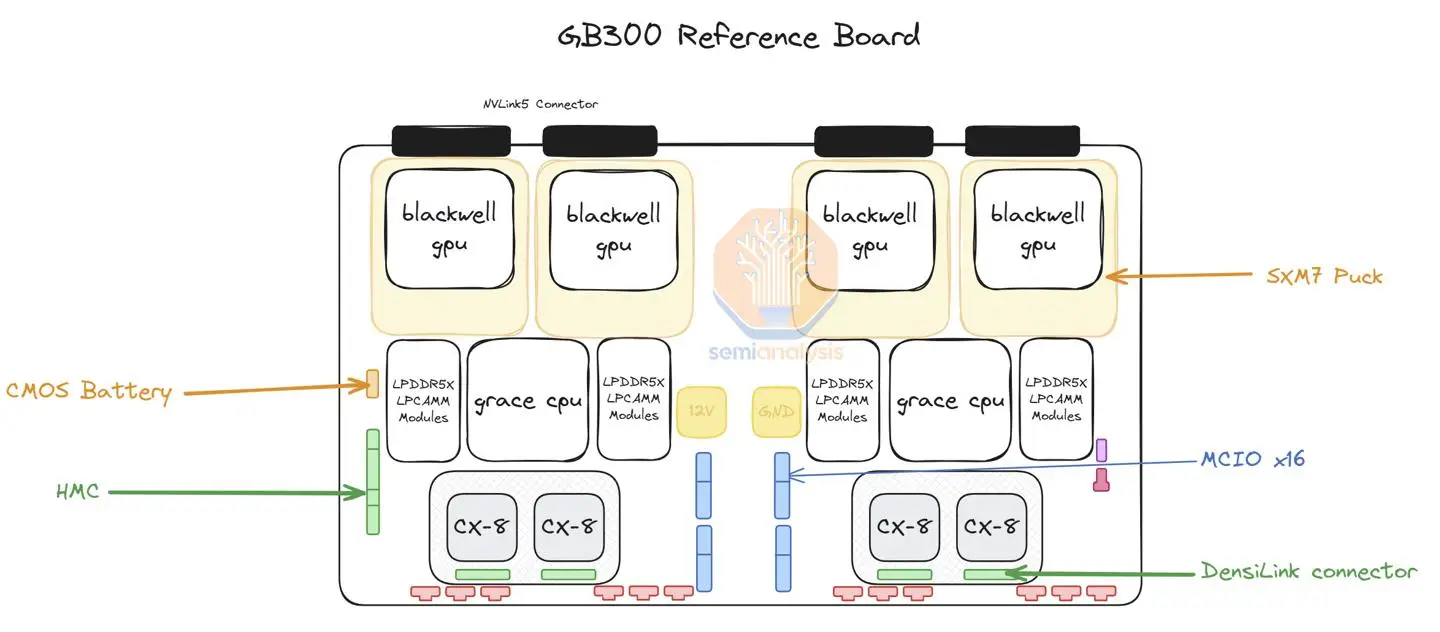
这种专用冷板设计是对不断增长的计算密度需求的直接响应。随着GB300芯片布局更加紧凑,传统的大型冷板已经无法满足散热要求。转向专用冷板不仅提高了冷却效率,还为未来的模块化升级铺平了道路。然而,这种重新设计显著增加了快速连接接头的数量和整体系统的复杂性。
2. 小型化联轴器和成本效率
GB300 采用新型 NVUQD03 快速连接接头,尺寸缩小至之前型号的三分之一,同时将单位成本从 70-80 美元 (GB200) 削减至 40-50 美元。这种重新设计满足了高密度布局要求,并显著降低了液体冷却系统的总成本。
3. 热效率和可靠性挑战
虽然小型化可能会增加泄漏风险,但 GB300 通过优化的密封工艺和严格的加速测试(包括插入-拔出循环和材料耐久性验证)确保稳定性。尽管冷板和歧管之间仍使用快速连接接头,但冷板侧现在采用凹进式母端口设计,在不影响坚固性的情况下实现更时尚的轮廓。
机架功率需求已经超越了空气冷却的极限,使得液体冷却成为必然的发展道路。根据维谛技术 (Vertiv) 数据:
- 机架密度低于 20kW:空气冷却仍然可行。
- 20kW–75kW 机架密度:采用热管后门热交换器的混合气液冷却对于热管理至关重要。
- 75kW以上机架密度:只有直接液体冷却解决方案才能解决高功率密度机架的极端热负载。
未来,AI GPU机架功率将远远超过100kW,液冷必不可少。
Dilight专注于AI基础设施前沿,在液冷技术领域处于领先地位,推出了 浸入式冷却光模块,包括800G、400G、200G型号。 Dilight 已在世界领先的浸没式冷却数据中心的实际部署中得到验证 浸入式冷却解决方案 提供热稳定性、无损传输和一致的高性能——支持可扩展、可持续的人工智能网络。
GB300 高速铜缆连接
在 GB200 服务器中,NVIDIA 首次引入了铜缆背板连接方案,单台 NVL72 服务器使用了近 5,000 根 NVLink 铜缆,总长度超过 2 英里。 GB300进一步优化了铜缆布局,电缆长度预计增加50%,以满足更高性能和更大数据传输需求。
GB300作为新一代AI服务器,标配CX8网卡,支持1.6T光模块(800G×2),对内部数据传输带宽提出了极高的要求。机柜内短距离互联场景(<5米)需要低时延、低功耗、高密度布线,1.6T铜缆(DAC或AEC)成为最佳技术解决方案。这些电缆的单通道速率为 224Gbps,可以满足通过聚合多个通道实现的高带宽要求。
困境 一直致力于提供高性能光网络解决方案,优先研究尖端技术和创新产品。凭借多年在人工智能行业的丰富经验和对市场趋势的精准把握,我们率先推出了 1.6T光模块 和 1.6T DAC线这一突破满足了超大规模数据中心和高性能计算环境中对超高带宽和低功耗的需求。 1.6T模块采用Dilight自主研发的硅光子芯片,每通道运行速度为200G,可确保海量AI数据集的快速传输,显著减少AI模型的训练和推理时间。要了解我们的1.6T光模块的性能详细信息,请参阅: 聚焦AI前沿:Dilight推出1.6T InfiniBand XDR硅光子光模块.
直连铜缆(DAC)凭借成本效益、低功耗、高可靠性等优势,已成为数据中心高速连接的首选。 Dilight的DAC线缆涵盖了从100G到1.6T的全速率解决方案,满足超大规模AI训练、实时推理等带宽密集型场景的需求。该线缆全面支持InfiniBand的超低延迟架构和基于RoCE的无损以太网,为GPU集群和AI计算中心提供零丢包和高度稳定的连接。请访问我们的网站了解更多详情 InfiniBand网络 和 RoCE 网络解决方案.
热门文章
相关产品:
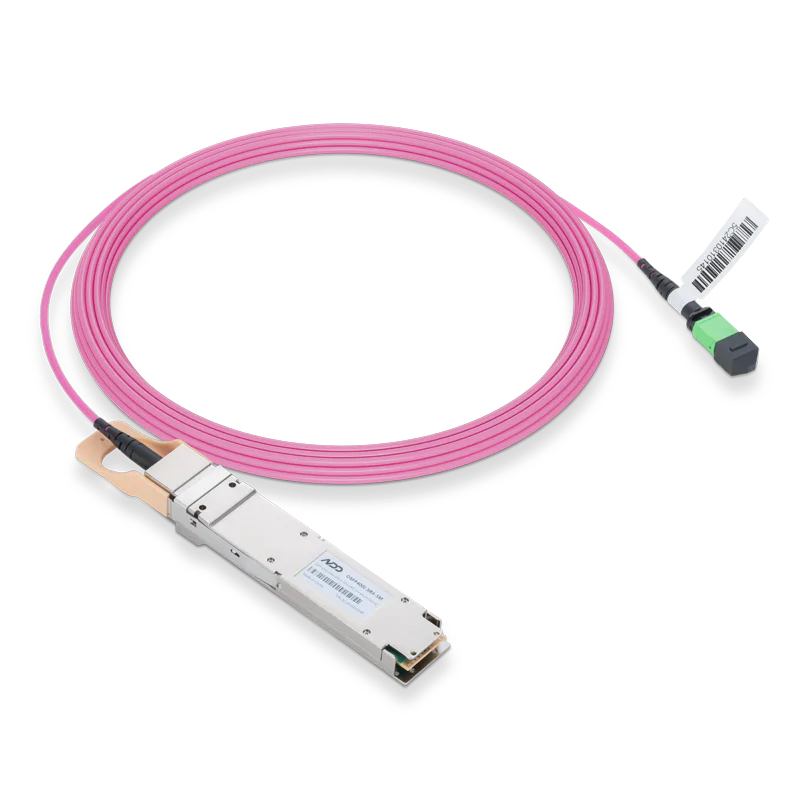
NVIDIA/Mellanox 兼容 400GBASE-SR4 OSFP RHS/平顶 4x100G PAM4 850nm 100m MMF DOM IB 和以太网液体/浸入式冷却光模块,带 3m MPO-12/APC OM4 Erika 紫色/洋红色母头 A 型尾纤
US$ 1,109.00
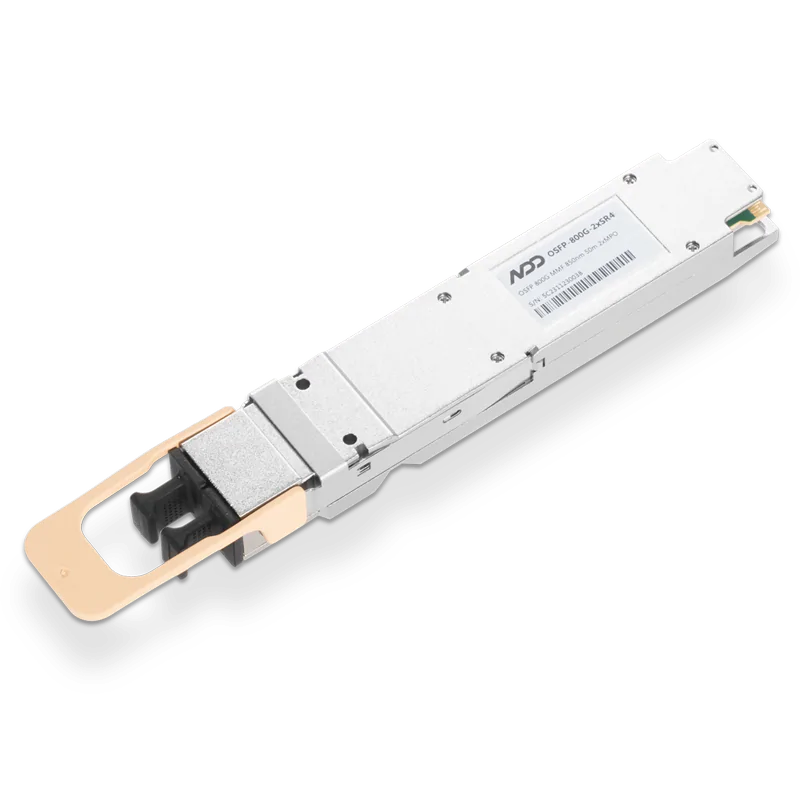
NVIDIA/Mellanox 兼容 800GBASE-2xSR4 OSFP IHS/Finned Top 8x100G PAM4 850nm 100m MMF DOM IB 和以太网液体/浸入式冷却光模块,带 3m 双 MPO-12/APC OM4 Erika 紫色/洋红色母头 A 型尾纤
US$ 1,379.00
NVIDIA/Mellanox 兼容 200GBASE-SR4 QSFP56 4x50G PAM4 850nm 100m MMF DOM IB 和以太网液体/浸入式冷却光模块,带 3m MPO-12/APC OM4 Erika 紫色/洋红色母头 A 型尾纤
US$ 309.00
NVIDIA/Mellanox MCX75310AAS-NEAT ConnectX®-7 InfiniBand 和以太网适配器卡,NDR 400Gb/s,单端口 OSFP,PCIe 4.0/5.0 x 16,高支架
US$ 1,499.00
NVIDIA/Mellanox MMS4A00-XM/MMS4C10-XM/MMS4C11 (980-9IAH1-00XM00/980-9IAU0-00XM01/980-9IAU1-00XM01) 兼容 1.6T 2xDR4 OSFP224 IHS/封闭翅片顶部 8x200G PAM4 Broadcom 3nm DSP (Sian3 | BCM83628) 1310nm 500m SMF DOM 双 MPO-12/APC InfiniBand XDR 光光模块模块,适用于 Quantum-X800 风冷交换机
US$ 1,469.00
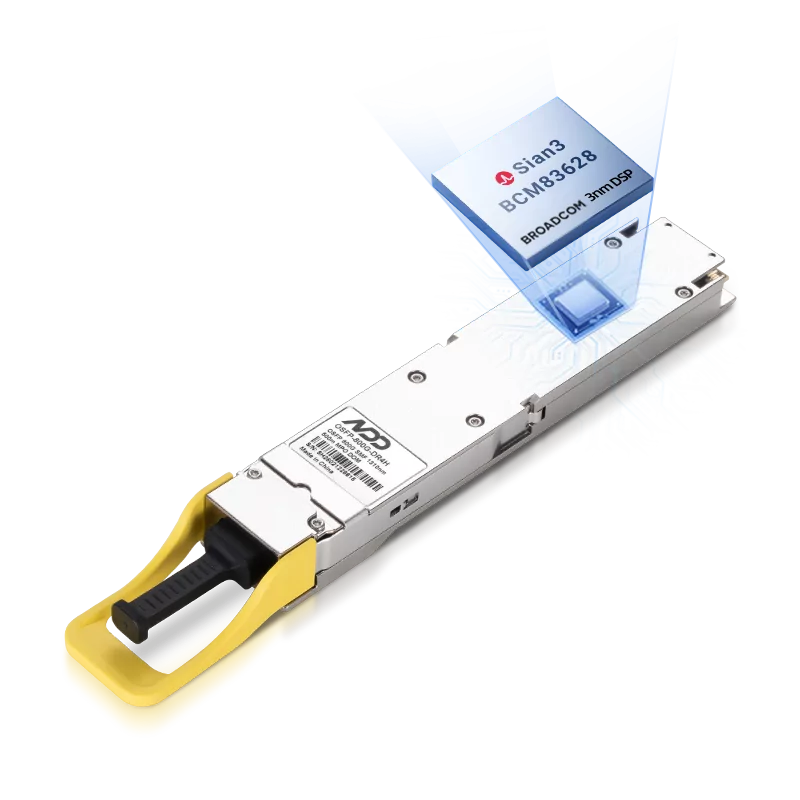
NVIDIA/Mellanox MMS4A20-XM800 (980-9IAT0-00XM00/980-9IAY0-00XM00) 兼容 800G DR4 OSFP224 RHS/平顶 4x200G PAM4 Broadcom 3nm DSP (Sian3 | BCM83628) 1310nm 500m SMF适用于 ConnectX-9/ConnectX-8/B300/GB300 的 DOM MPO-12/APC InfiniBand XDR 光光模块模块
US$ 1,099.00
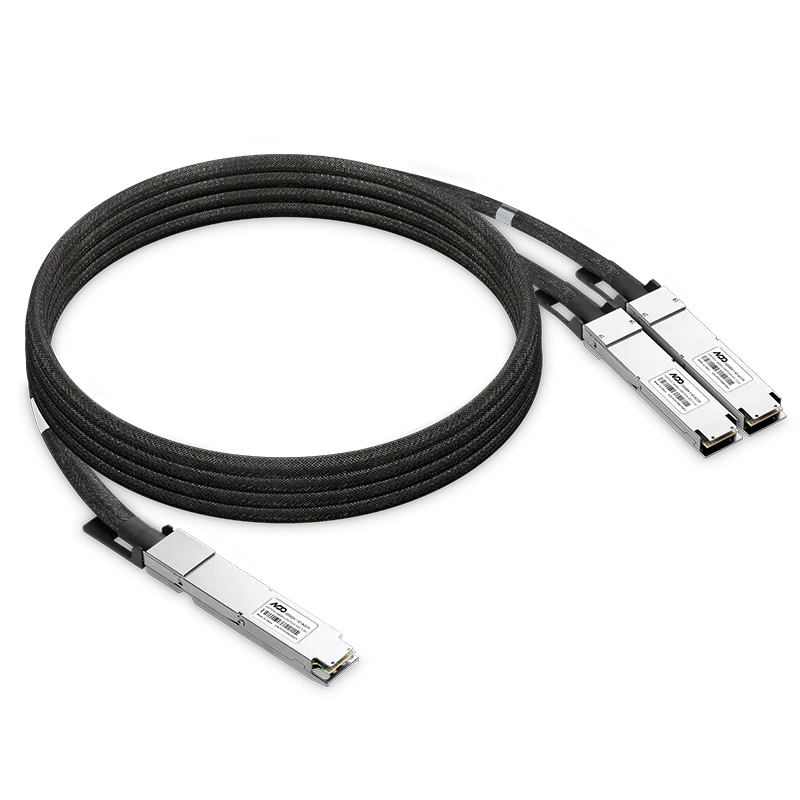
2.5m (8.2ft) NVIDIA/Mellanox MCA7K10-X02A (980-9IAO5-00X02A) 兼容 1.6T ACC OSFP224 IHS/封闭翅片顶部 8x200G PAM4 至 2x800G OSFP224 RHS/平顶 4x200G PAM4 InfiniBand XDR 有源铜缆分路器电缆
US$ 1,589.00
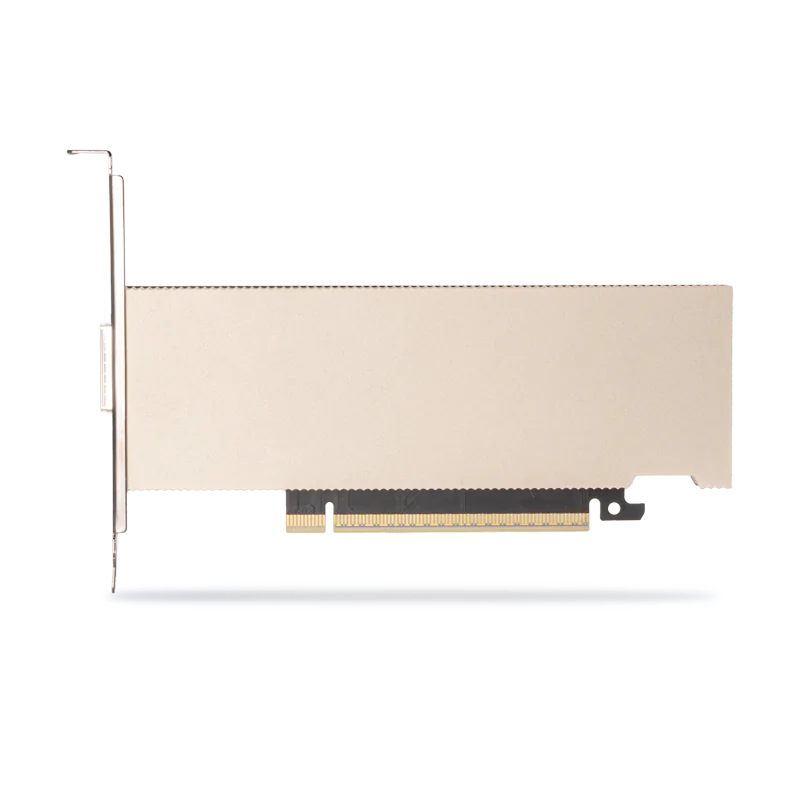
NVIDIA/Mellanox C8180 (900-9X81E-00EX-ST0) ConnectX-8 InfiniBand 和以太网 SuperNIC、Socket-Direct XDR 800Gb/s PAM4 200G/通道、单端口 OSFP、PCIe 6.0 x 16、高支架
US$ 1,679.00
寻找理想的光纤和连接解决方案来提升您的网络!