AIDC 布线专为超高带宽、多平面拓扑、极端端口密度和热受限环境而设计。它不仅仅是连接设备,还充当物理层基础,使超大规模 GPU 集群能够可靠地部署、扩展和运行。
Loading content… / 正在加载内容…
人工智能数据中心(AIDC)是指专门为大规模人工智能训练、推理和高性能GPU计算而构建的下一代数据中心基础设施。与传统的企业或云数据中心不同,AIDC的特点是GPU之间东西向流量巨大,依赖于超高带宽、低延迟互连和紧密耦合的分布式计算架构。
现代人工智能训练需要数千个GPU作为统一的分布式系统运行,推动了对超高带宽、超低延迟和海量东西向流量的前所未有的需求。传统的数据中心架构已经无法满足这些需求。
AIDC 布线专为超高带宽、多平面拓扑、极端端口密度和热受限环境而设计。它不仅仅是连接设备,还充当物理层基础,使超大规模 GPU 集群能够可靠地部署、扩展和运行。
Dilight MPO 解决方案为 AI 结构提供基础光学连接,支持跨大规模 AI 集群的直接 GPU 互连和结构化布线架构。
在现代 AIDC 部署中,MPO 不仅支持 GPU 服务器和交换机之间的点对点连接,而且还充当跨叶层、主干层和核心层的结构化互连的主干介质。通过结合高密度 MPO 主干、分支组件和模块化接插架构,Dilight 为 400G、800G 和未来 1.6T AI 网络提供可扩展、有序且低延迟的光学基础设施。
从 GPU-ToR 访问层到脊叶骨干互连,Dilight MPO 组件为超大规模 AI 部署提供了标准化且可扩展的物理层基础。
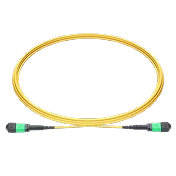
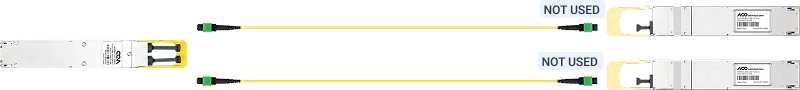
专为AI服务器与ToR/Leaf交换机之间的高速直连而设计,支持400G和800G中短距离互连。充当 GPU 机架内的接入层光学链路。
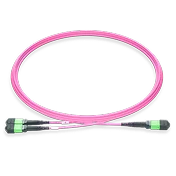
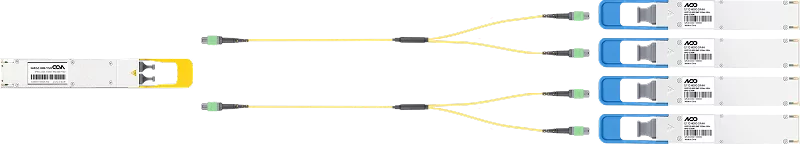
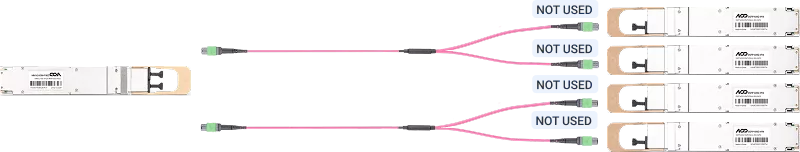
在 AI 结构内实现灵活的通道分配,支持 1.6T 至 2×800G、800G 至 4×200G 以及 400G 至 4×100G 突破架构,以实现可扩展的 GPU 互连。
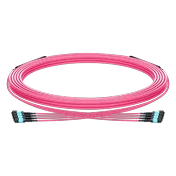
充当 Spine-Leaf AI 集群架构的结构化骨干。部署在机架或配线区域之间,支持高密度聚合、插入损耗控制和长期可扩展性。
为结构化布线系统提供有组织的光纤端接、路由和管理。在高密度部署中实现清晰的通道识别、简化维护并改进气流和热性能。
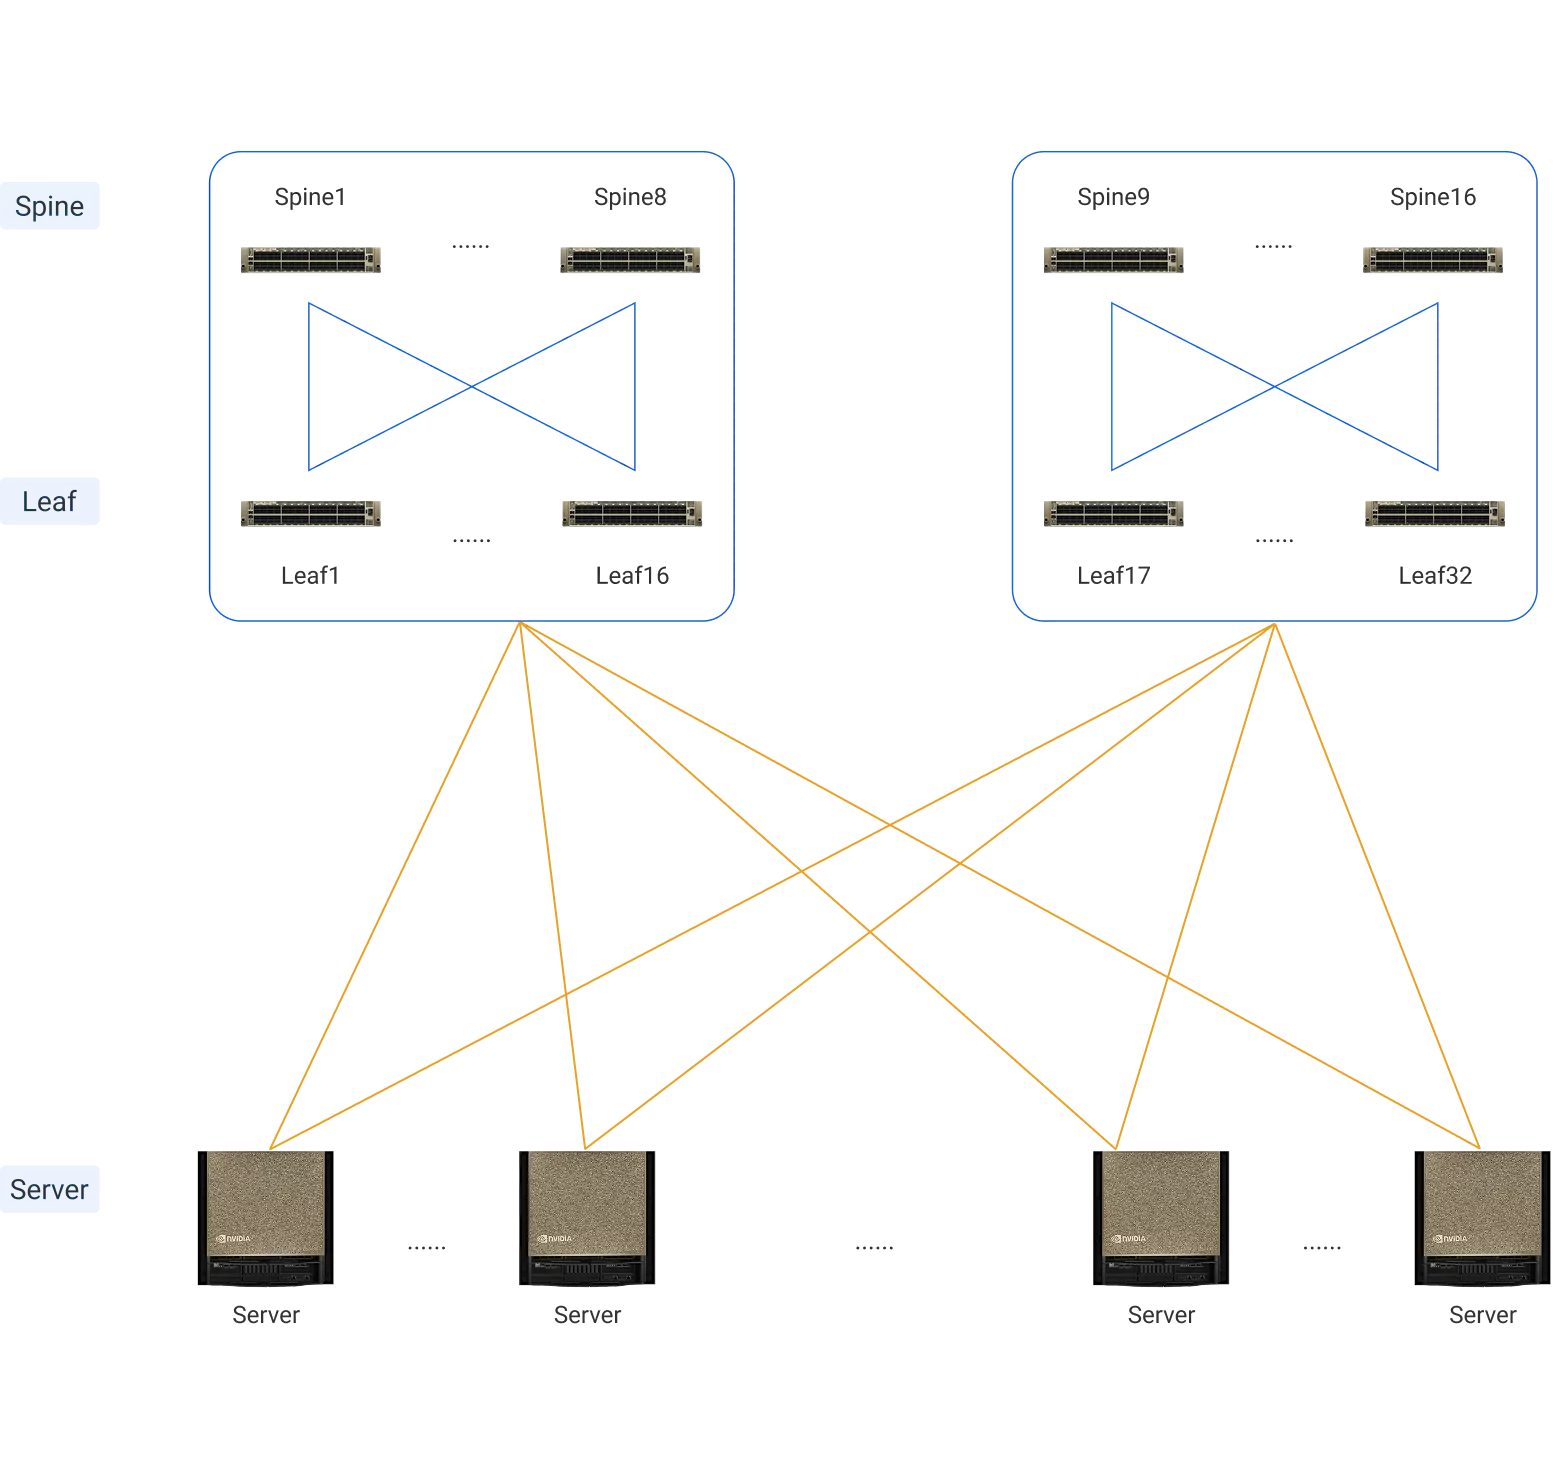
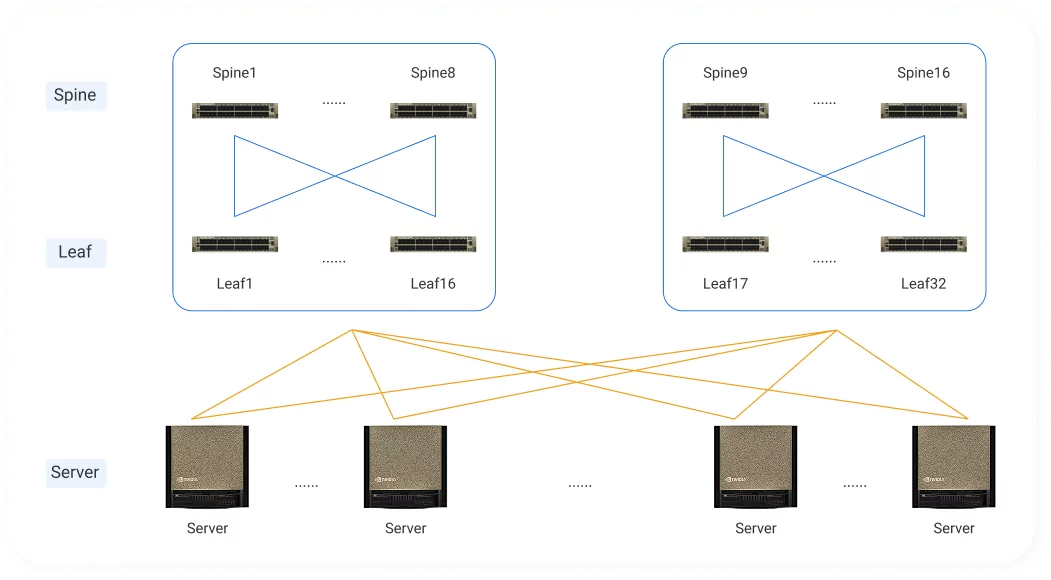
多平面网络的核心挑战不是带宽,而是大规模跨平面光纤连接的物理管理。随着 AI 集群扩展到数万个 GPU,每个 GPU 必须跨多个独立平面进行连接。传统的手动点对点修补很容易出错并且无法扩展。 Shuffle是专为多平面AI结构设计的结构化光学互连解决方案。通过在工厂层面标准化和重组跨交换机、多通道光纤链路,它将复杂的网络连接转变为预先设计的、可重复的布线系统。这种方法显著减少了现场修补和拼接工作,最大限度地减少了安装错误,并为超大规模人工智能集群提供了稳定、可扩展的物理层基础。
工厂预端接的混合电缆支持速率分解和多平面交叉连接,显著减少现场修补和拼接工作,最大限度地减少安装错误,实现可扩展的网络架构,同时保持高信号完整性。
机架级集成解决方案支持每 1U 多达 256 根光纤,旨在集中光纤端接并实现结构化光路由。它简化了超大规模人工智能网络的扩展和维护,同时减少了电缆拥塞和交叉布线的复杂性,提高了机架空间利用率和热效率。
随着人工智能集群、HPC 和超大规模数据中心不断增加端口密度,传统 MPO 连接器正在成为高密度布线环境中的瓶颈。有限的机架空间使得支持下一代 AIDC 部署所需的不断增长的光纤链路数量变得越来越困难。为了应对这些挑战,Dilight提供基于VSFF技术的MMC高密度连接解决方案。与传统 MPO 相比,MMC 在相同的占地面积内提供更高的端口密度,同时保持低插入损耗和可靠的性能,以实现可扩展的 AI 数据中心布线。
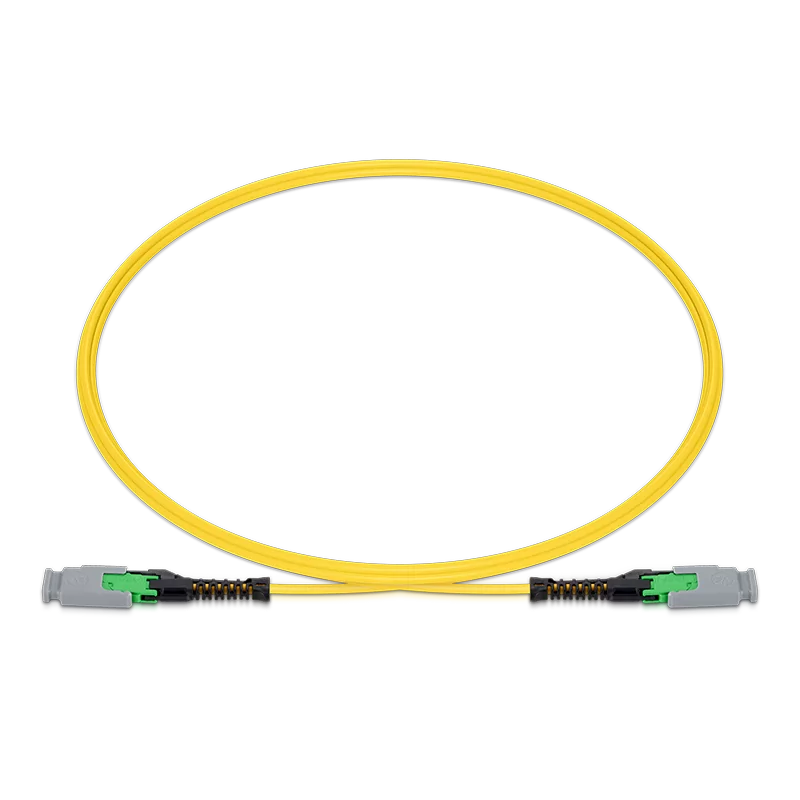
用于高密度机架内互连的 MMC 到 MMC 连接。提供 MMC12、MMC16 和 MMC24 配置。 MMC-12 连接器与 NVIDIA SN6800 和 SN6810 CPO 交换机兼容。
MMC 到 MPO 转换电缆,可与现有 MPO 基础设施无缝集成。典型配置包括 MMC12 至 MPO12、MMC16 至 MPO16 和 MMC24 至 MPO24。
MPO-12 至 MPO-12 OS2 12F B 型

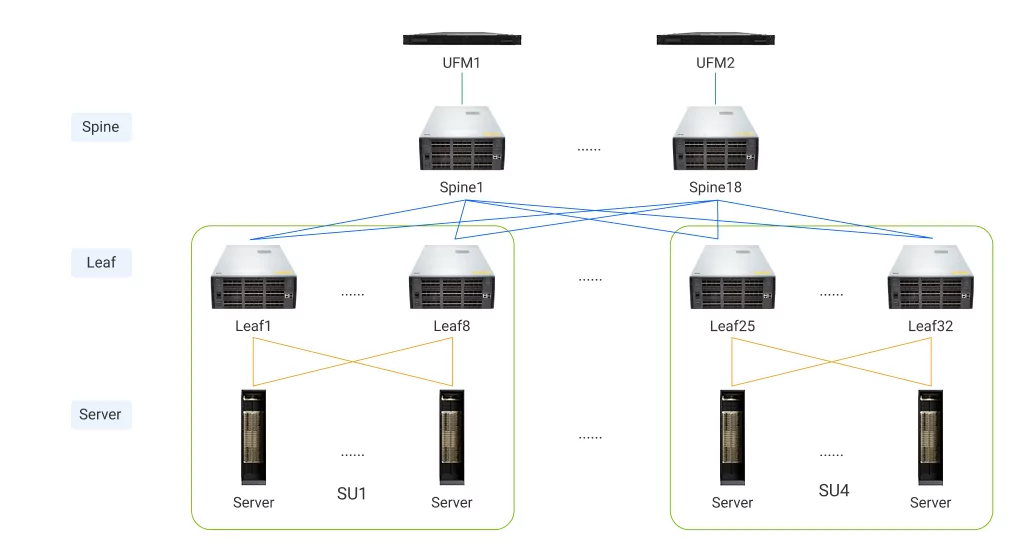

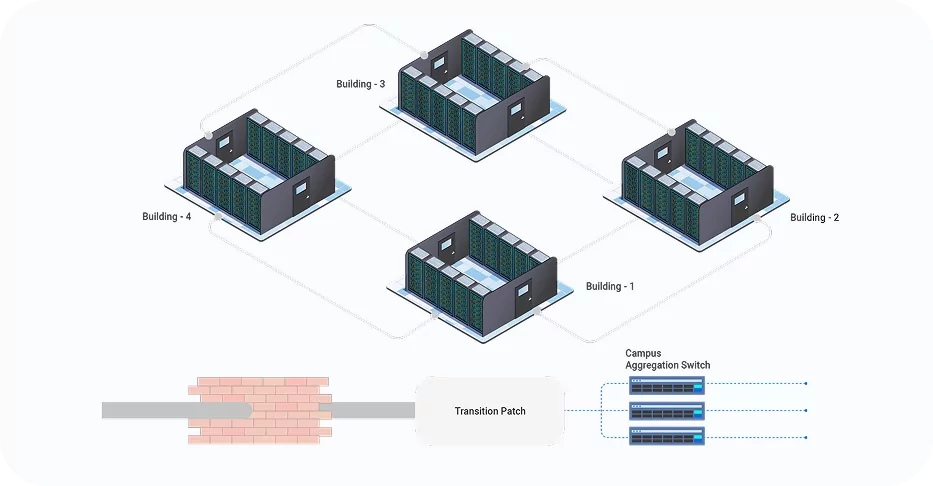
结构化布线是一种标准化和模块化架构,用于管理人工智能数据中心的网络连接。通过使用主干链路、配线架和高密度光纤组件,它可以跨大规模 GPU 集群实现有组织、可扩展且可靠的互连。它还可以减少电缆拥塞,简化扩展和维护,并为400G/800G/1.6T AI Fabric提供可靠的物理层基础。
与传统点对点布线相比,结构化布线可减少部署时间约70%,降低部署成本(人工成本)约60%,提升运营效率约60%,显著提升大型AI数据中心的整体效率。
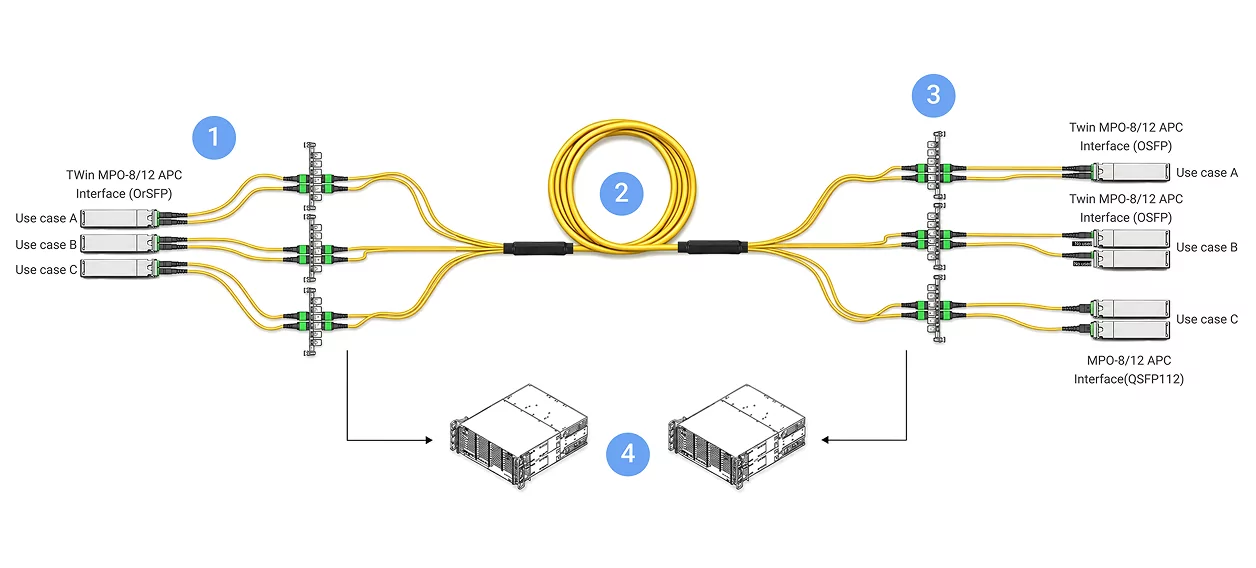
MPO-8 至 MPO-8 APC(母头),8 芯跳线,B 型
预端接 MPO 192F 24xMPO-8(公头)至 24xMPO-8(公头)干线电缆
12 x MPO-8 B 型适配器面板
1U 机架安装外壳空载
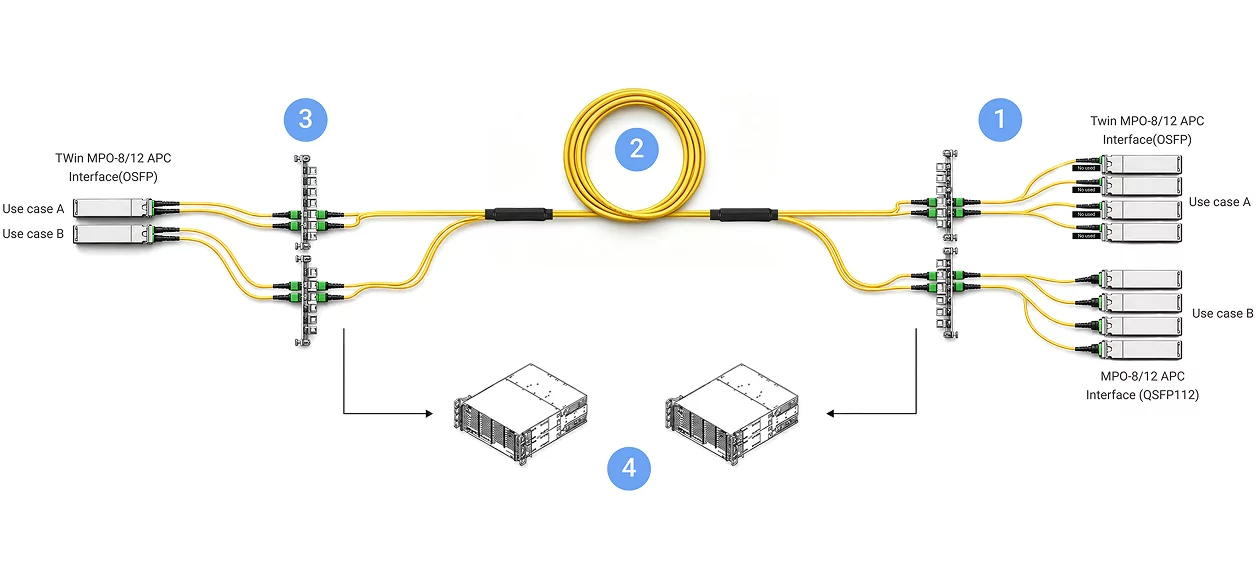
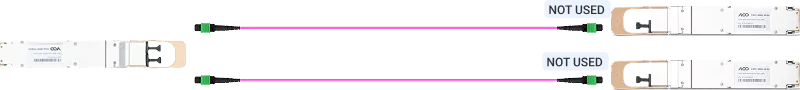
MPO-8 至 2xMPO-4 APC(母头),8 芯分支电缆,B 型
预端接 MPO 192F 24xMPO-8(公头)至 24xMPO-8(公头)干线电缆
12 x MPO-8 B 型适配器面板
1U 机架安装外壳空载
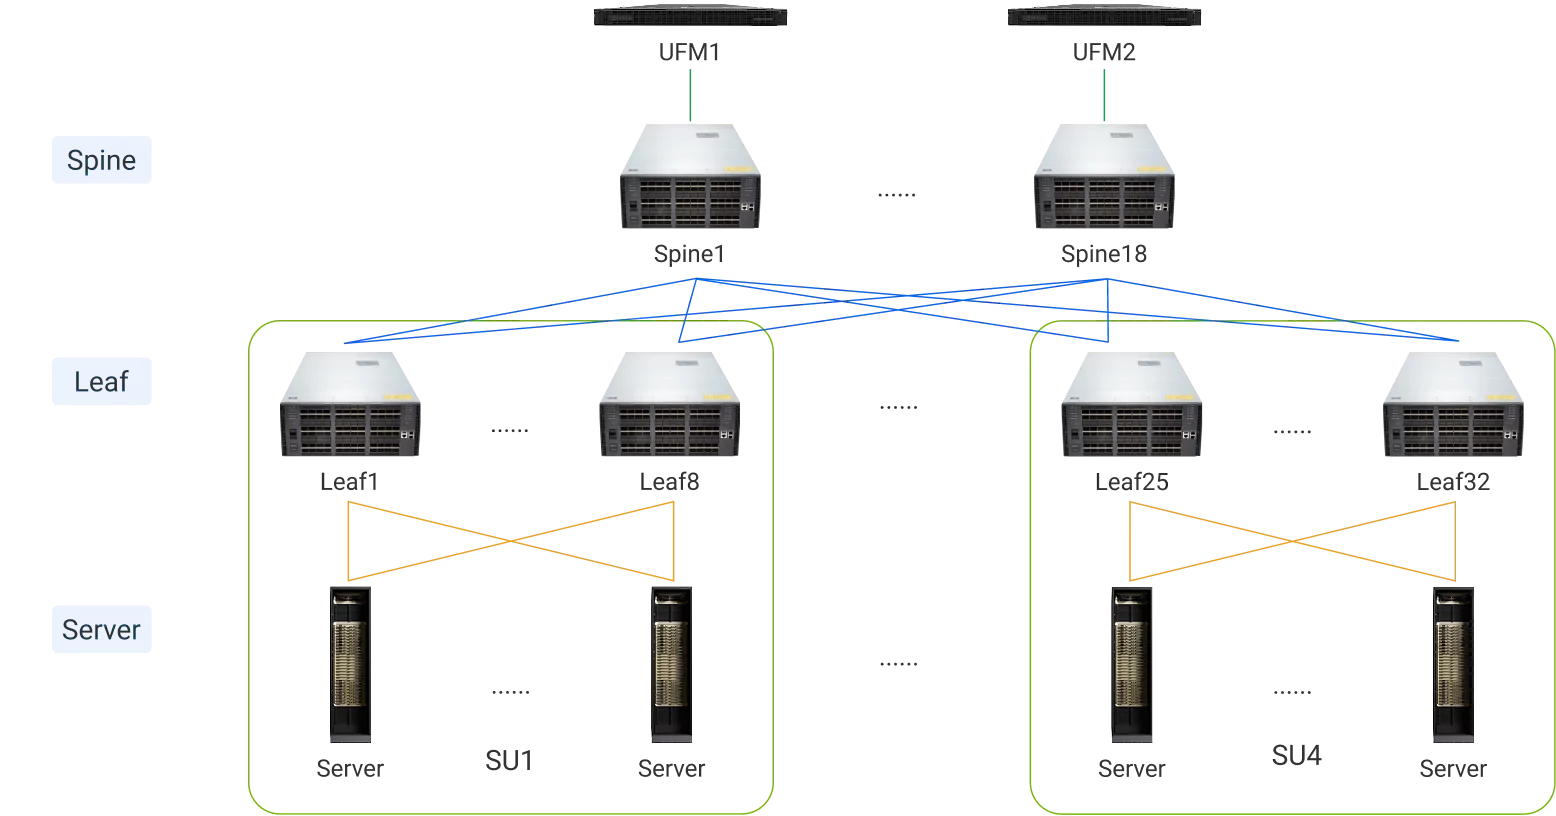
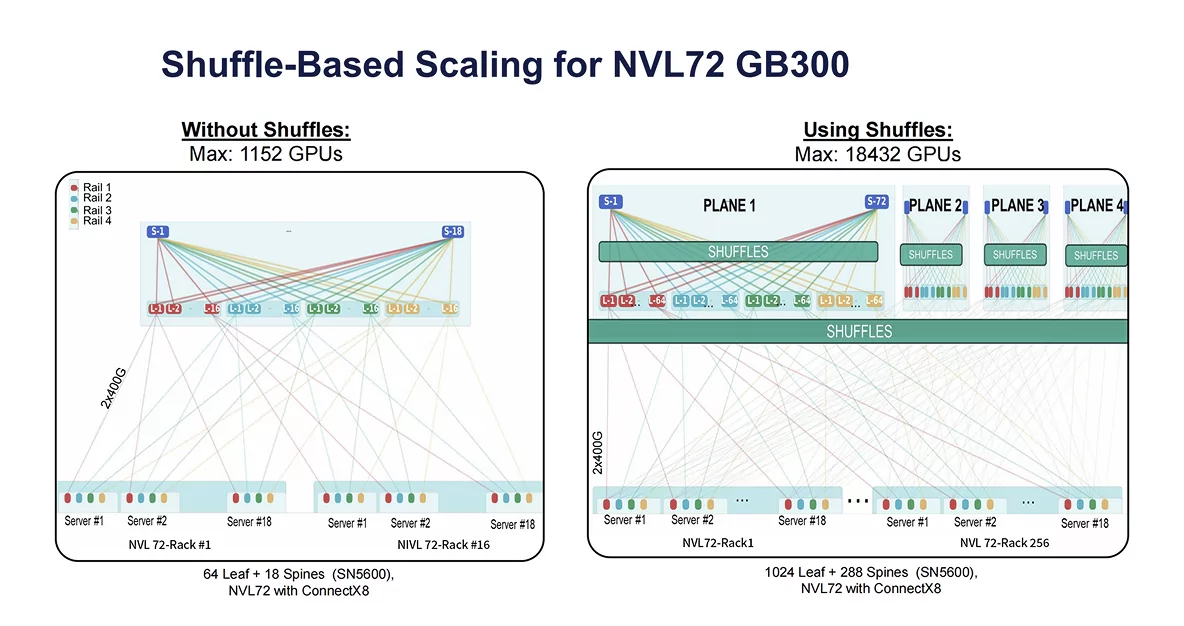
通过传统的直接布线,单个 GB300 NVL72 集群最多可支持 1,152 个 GPU。用定制的 2x2 Shuffle Cable 取代传统布线后,同一集群可支持多达 18,432 个 GPU,集群容量增加了 16 倍。每个 GPU 通过以 2x400G 速度运行的 ConnectX-8 NIC 连接,通道被分解和重组,以创建丰富的结构化网状网络。
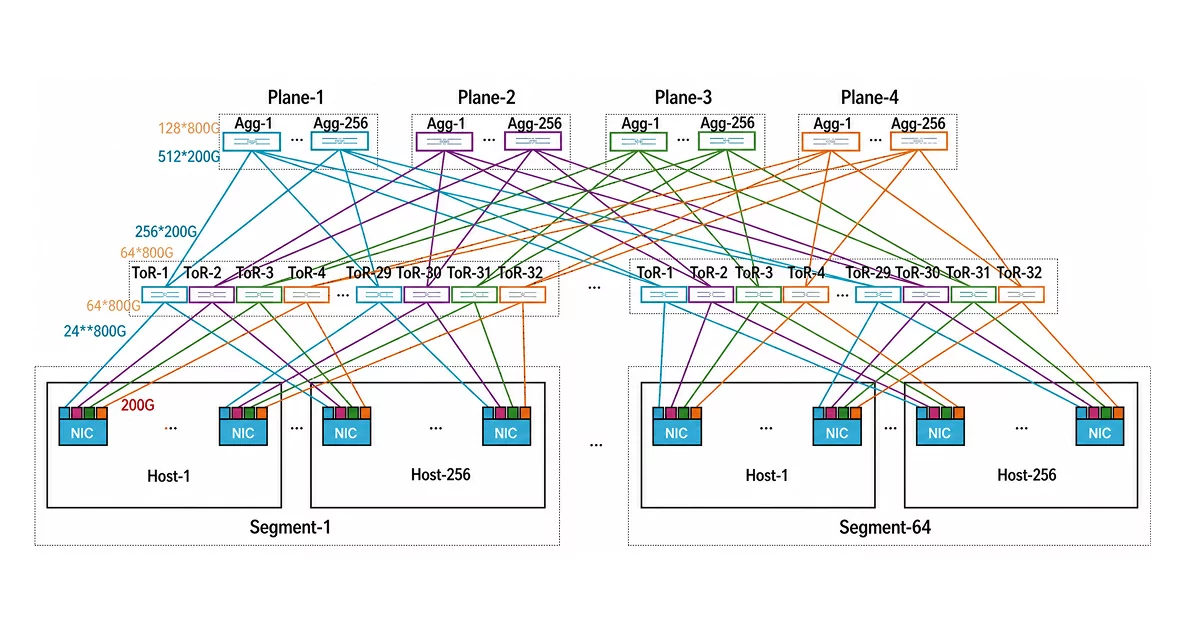
客户将其现有的 HPN-7.0 双平面架构升级为四平面设计,将服务器连接从 2x200GE 扩展到 4x200GE。通过部署与HPN-7.0端口布局相匹配的定制Shuffle Cable,布线体积减少80%,机架空间利用率下降60%,LLM培训效率提高35%。
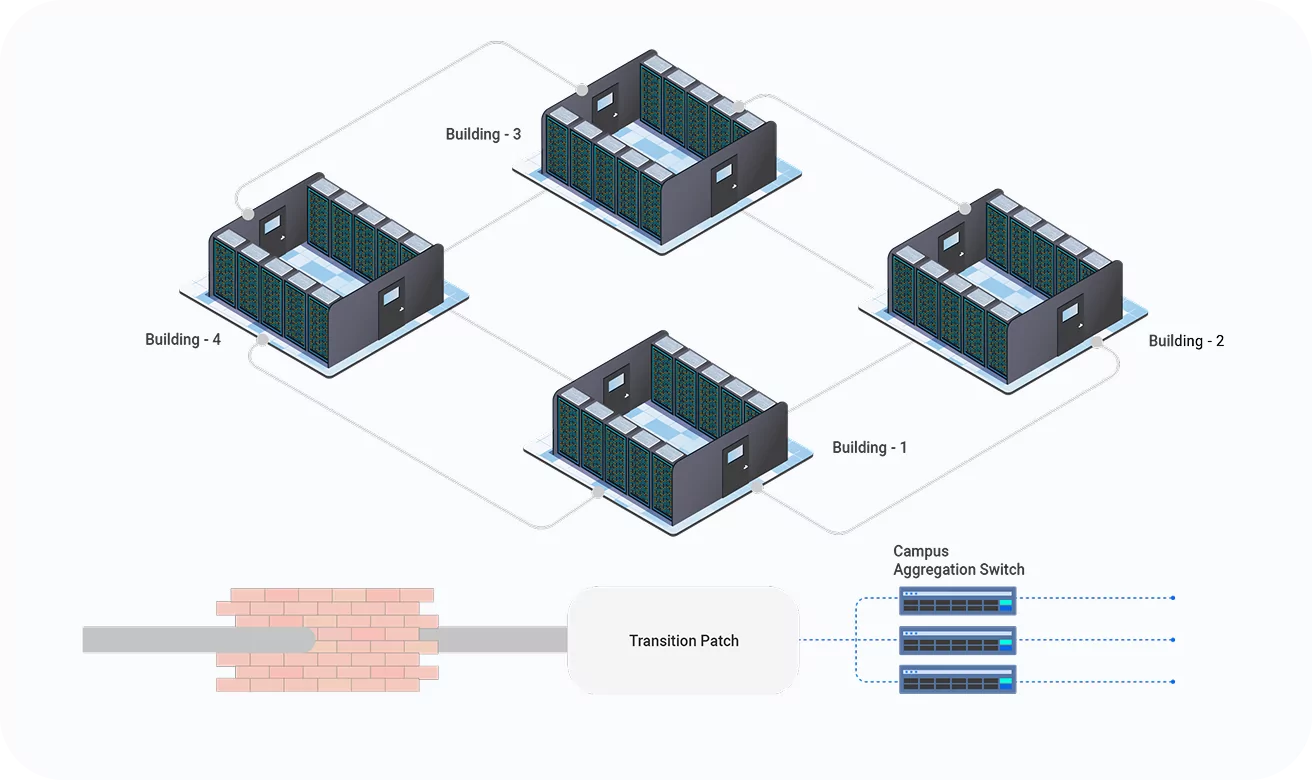
MMC 取代了传统的 MPO/LC,为每个机架提供更高的光纤端口密度,同时释放冷却和气流空间。
在大型数据中心园区中,单根高密度光缆最多可支持6,912根光纤。 MMC 的紧凑设计使工厂预端接组件能够快速部署在空间受限的路径中,从而减少安装时间并最大限度地降低停机风险。
MMC满足CPO和NPO架构的高密度光纤连接要求。它节省了从光学引擎到卡边缘的高密度布线空间,同时提供足够的冷却和气流条件。
Shuffle解决方案的工厂预端接即插即用模型显著缩短了部署时间,帮助客户在大模型训练中掌握主动;模块化设计,支持弹性扩展,无需修改现有基础设施,保护前期投资。
大幅减少物理连接点,显著降低故障排除和跳线更换成本;释放大量机架空间,提高热效率,间接降低制冷能耗;与现有 MPO 基础设施兼容,可实现平稳、分阶段升级。
单独的光纤封装加上优化的光纤弯曲半径可提高抗振性并减少微弯损耗,从而增强链路稳定性; DirectConec™ 推拉式护套设计即使在密集布线环境中也能轻松插入/移除;可视化光纤布线,故障定位更快、更准确。
大幅减少物理连接点数,显著降低多平面网络的故障率;工厂预端接消除了手动修补错误,提高了链路可靠性。
在传统的AI集群布线中,连接依赖于现场熔接、手动跳线和点对点路由。随着 GPU 数量的增加,这种方法会导致部署延迟、电缆拥塞和扩展僵化。相比之下,基于工厂预端接、结构化路由和模块化架构构建的 AIDC 布线在方法层面消除了这些限制。


随着 AI 集群从数千个 GPU 扩展到数十万个 GPU,物理层在端口密度、光纤映射复杂性和热管理方面面临着前所未有的压力。最新一代 AI 网络平台(包括 NVIDIA Spectrum-X、Cisco Silicon One G200、Broadcom Tomahawk 6 和 Arista XPO)正在通过极高的端口密度、超高交换带宽和功耗优化设计重塑 AI 基础设施。 Dilight 的高密度、预先映射和面向未来的布线解决方案专为这种多供应商发展而构建,使 AI 基础设施能够从小型集群无缝扩展到百亿亿次部署。
现代 AI 交换机不断提高前面板带宽密度,以支持更大的 GPU 结构和更高的机架吞吐量。 NVIDIA Spectrum 和 Cisco Silicon One 等平台正在推动 64×800G 和更高密度的交换机配置,给前面板空间、冷却效率和电缆管理带来了重大挑战。