Loading content… / 正在加载内容…
Blackwell Ultra 用于更高密度的人工智能计算
为什么选择 DGX B300
随着 LLM 参数大小、上下文长度和推理并发性的不断扩展,AI 基础设施正在从仅仅提高 GPU 计算转向提高整体系统效率。 B300 由 Blackwell Ultra 架构提供支持,可提供更高的计算性能和更大的 HBM3e 容量,为大规模 AI 训练、推理和 AI 工厂奠定更坚实的基础。
B300配备288GB HBM3e内存和8TB/s内存带宽,FP4 Tensor Core性能高达15 PFLOPS。与 B200 相比,B300 具有更大的内存容量、更高的 FP4 性能和更高的 TDP,使更大的模型能够以更少的 GPU 运行。
英伟达 DGX
B200
FP4 性能
9浮点运算次数
HBM3e
192GB
标准网卡
ConnectX-7 400Gb/s
技术兼容性
基本/MoE 型号 (≤200B)上下文长度 ≤ 128K 令牌
最适合工作负载
大规模集群训练
英伟达 DGX
B300
FP4 性能
15浮点运算次数+67%
HBM3e
288GB+50%
标准网卡
ConnectX-8 800Gb/s
技术兼容性
万亿参数/MoE 模型上下文长度 ≥ 256K / 百万令牌
最适合工作负载
超高并发推理& 极限训练
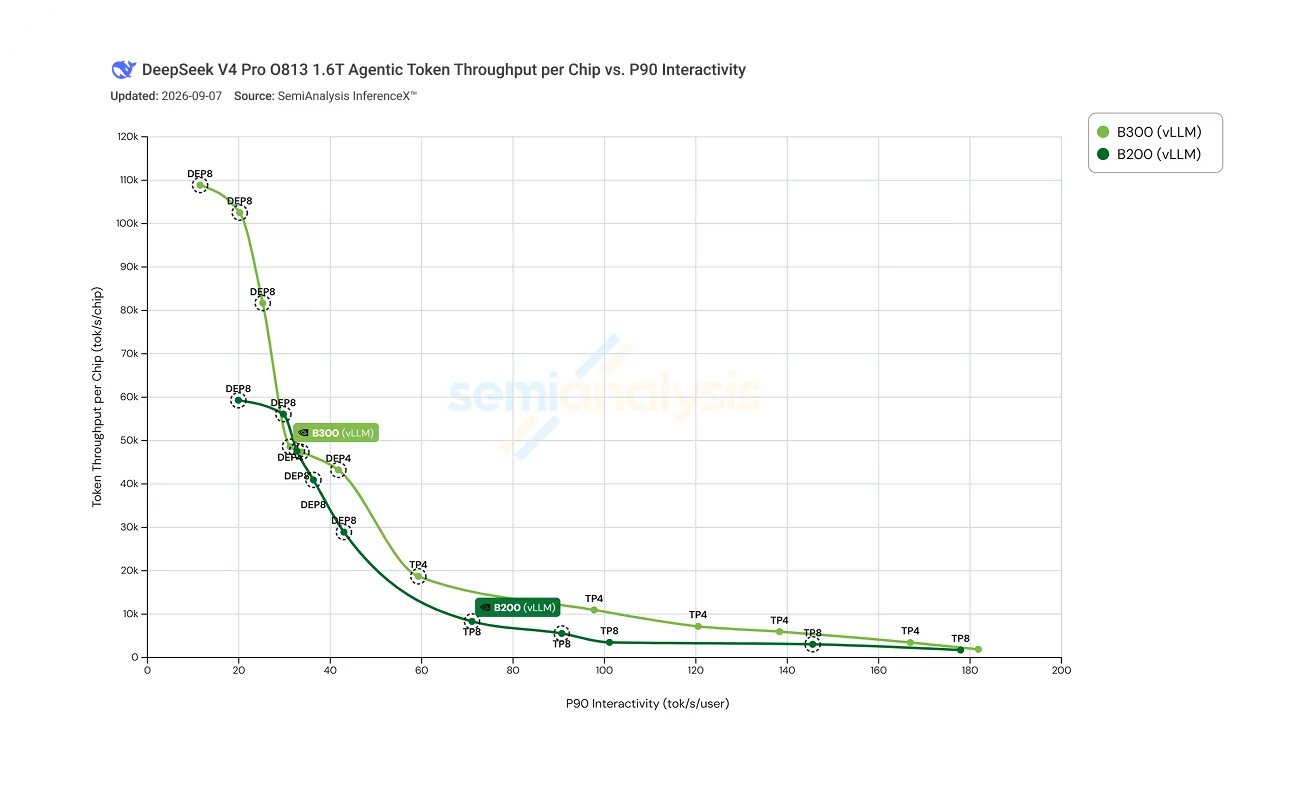
数据图表由 半分析
代理工作负载中的 B200 与 B300 性能基准
B300 基于 DeepSeek V4 Pro 1.6T(FP4、使用 vLLM 的 Agentic)的最新 SemiAnalysis InferenceX™ 基准,展示了 LLM 服务性能的根本性转变。在低延迟情况下(P90 E2E 延迟 < 60 秒),B300 的令牌吞吐量提高了 2 倍,证明其 15 PFLOPS FP4 计算有效解决了高并发预填充/解码阶段的计算限制瓶颈。随着批量大小和延迟限制的扩大,由于 HBM 容量限制,B200 在约 60k tok/s/芯片上达到了稳定水平,而 B300 的 288GB HBM3e 可以无缝处理超大 KV 缓存保留,在约 110k tok/s/芯片上解锁了 83% 的更高吞吐量上限。
这一轨迹证实了 B300 对于复杂、多轮 Agentic 交互的卓越计算到内存架构。
构建人工智能基础设施:从 B300 GPU 到 DGX SuperPOD
节点级:将 8 个 B300 GPU 集成到 DGX B300 中
B300 GPU 不是独立的计算系统。在 DGX B300 内,八个 B300 GPU 通过第五代 NVLink 和 NVSwitch 互连,在机箱内形成超高带宽的 Scale-Up 网络。同时,每个节点通过 InfiniBand 或以太网集成八个 ConnectX-8 SuperNIC,用于节点间横向扩展通信。作为将单个 GPU 桥接到 SuperPOD 集群的主要计算单元,DGX B300 的价值不仅仅在于原始计算能力,它还在于将 GPU、SuperNIC、交换结构和物理互连无缝统一到低延迟、高度可扩展的集成节点架构中。
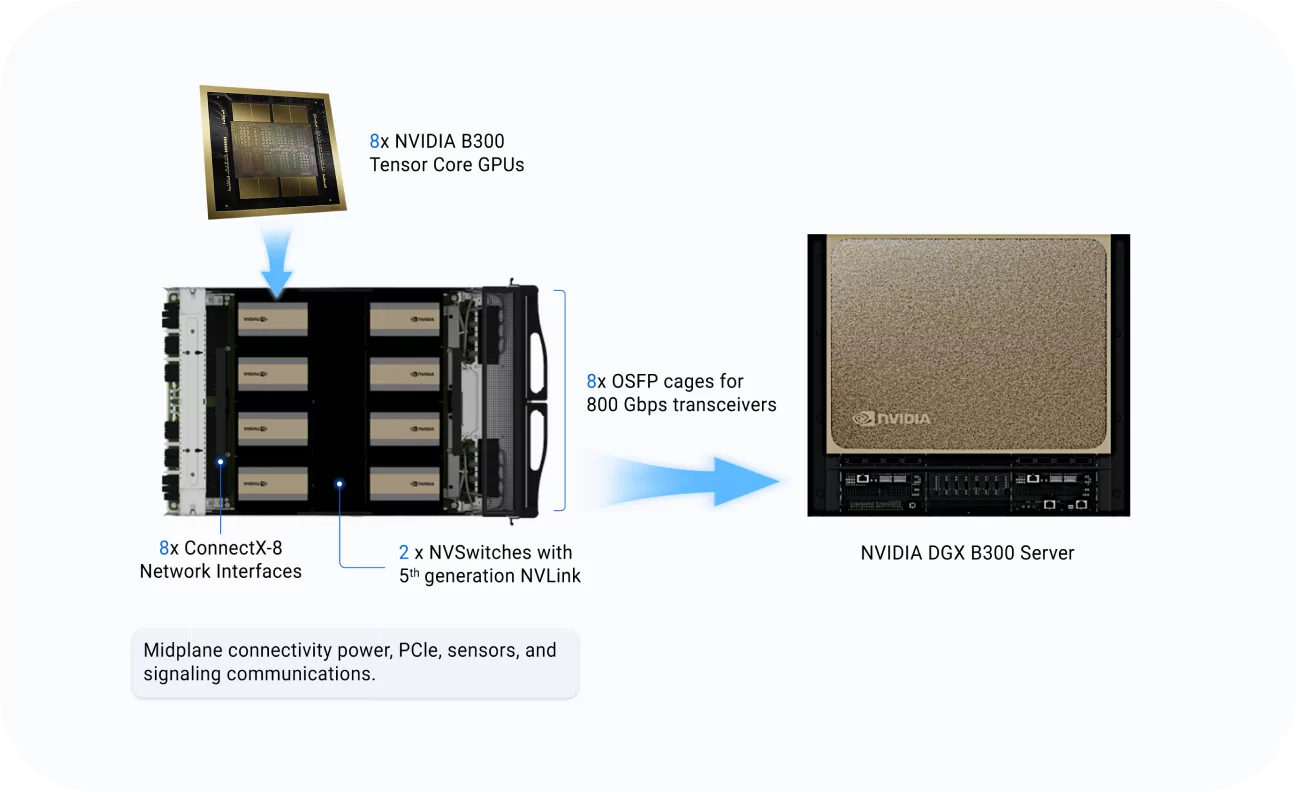
图片由以下人员提供 英伟达
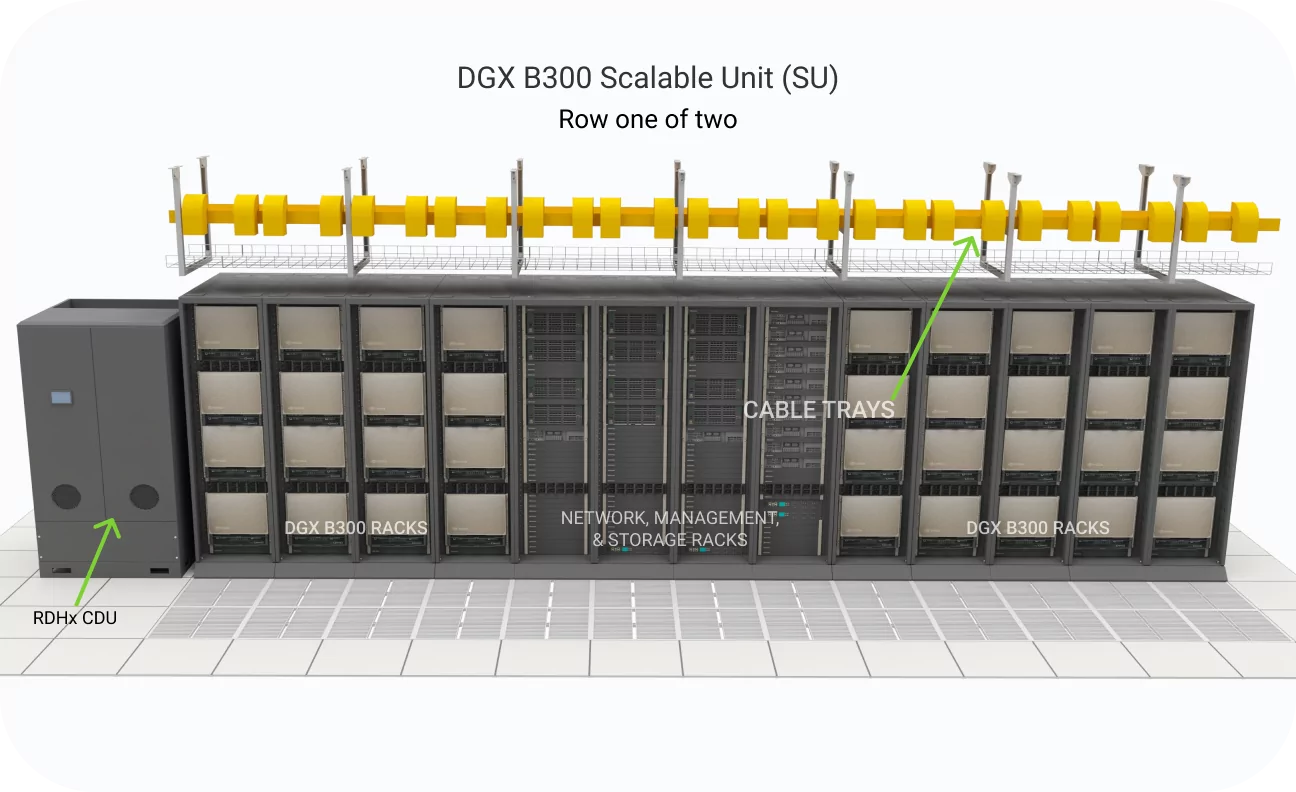
图片由以下人员提供 英伟达
模块化级别:将 DGX B300 节点扩展为可扩展单元
为了支持超出单节点限制的 AI 工作负载,多个 DGX B300 系统通过高速计算网络聚合为标准化可扩展单元 (SU)。该模块化计算单元集成了计算节点、网络交换和管理基础设施,支持多达 72 个用于 XDR 的 DGX B300 系统或 64 个用于 Spectrum‑X 的 DGX B300 系统,并提供高密度和低密度部署选项。

高密部署
每个 48U MGX 机架有四个风冷 DGX B300 系统,配备主动后门热交换器。

低密度部署
每个 48U/52U 机架有两个传统风冷 DGX B300 系统。
集群级别:将 SU 连接到全尺寸 DGX SuperPOD
在数据中心规模,多个SU通过两层、非阻塞横向扩展交换结构互连,形成完整的DGX SuperPOD。底层架构将高速节点内 GPU 互连(由 NVLink/NVSwitch 提供支持)与强大的节点间横向扩展网络(由 ConnectX-8 和高速交换机支持)无缝集成。即使集群扩展到数万个 GPU,这种分层架构也能确保超低延迟、充足的无阻塞带宽以及因增加网络层次结构而带来的额外通信开销最小化。
DGX B300 SuperPOD 网络架构
当多个DGX B300系统组合成一个SuperPOD时,网络不再仅仅是连接服务器的基础设施,而是整个AI集群的核心通信骨干。根据不同的工作负载职责,SuperPOD通常需要跨计算、存储和管理平面进行结构化流量规划,以确保高性能GPU通信、数据访问和系统管理在隔离的网络平面上稳定运行。
计算结构是 GPU 集群的主要骨干,处理集体通信、参数同步和节点间数据交换。逻辑上,轨内节点连接到同一Leaf交换机进行单跳转发,而跨轨或跨SU流量则通过Spine层路由。 B300 计算结构由 ConnectX-8(支持 InfiniBand 和以太网)提供支持,可提供全线速、超低延迟和无阻塞转发,以满足 AI 工作负载的高并发需求。
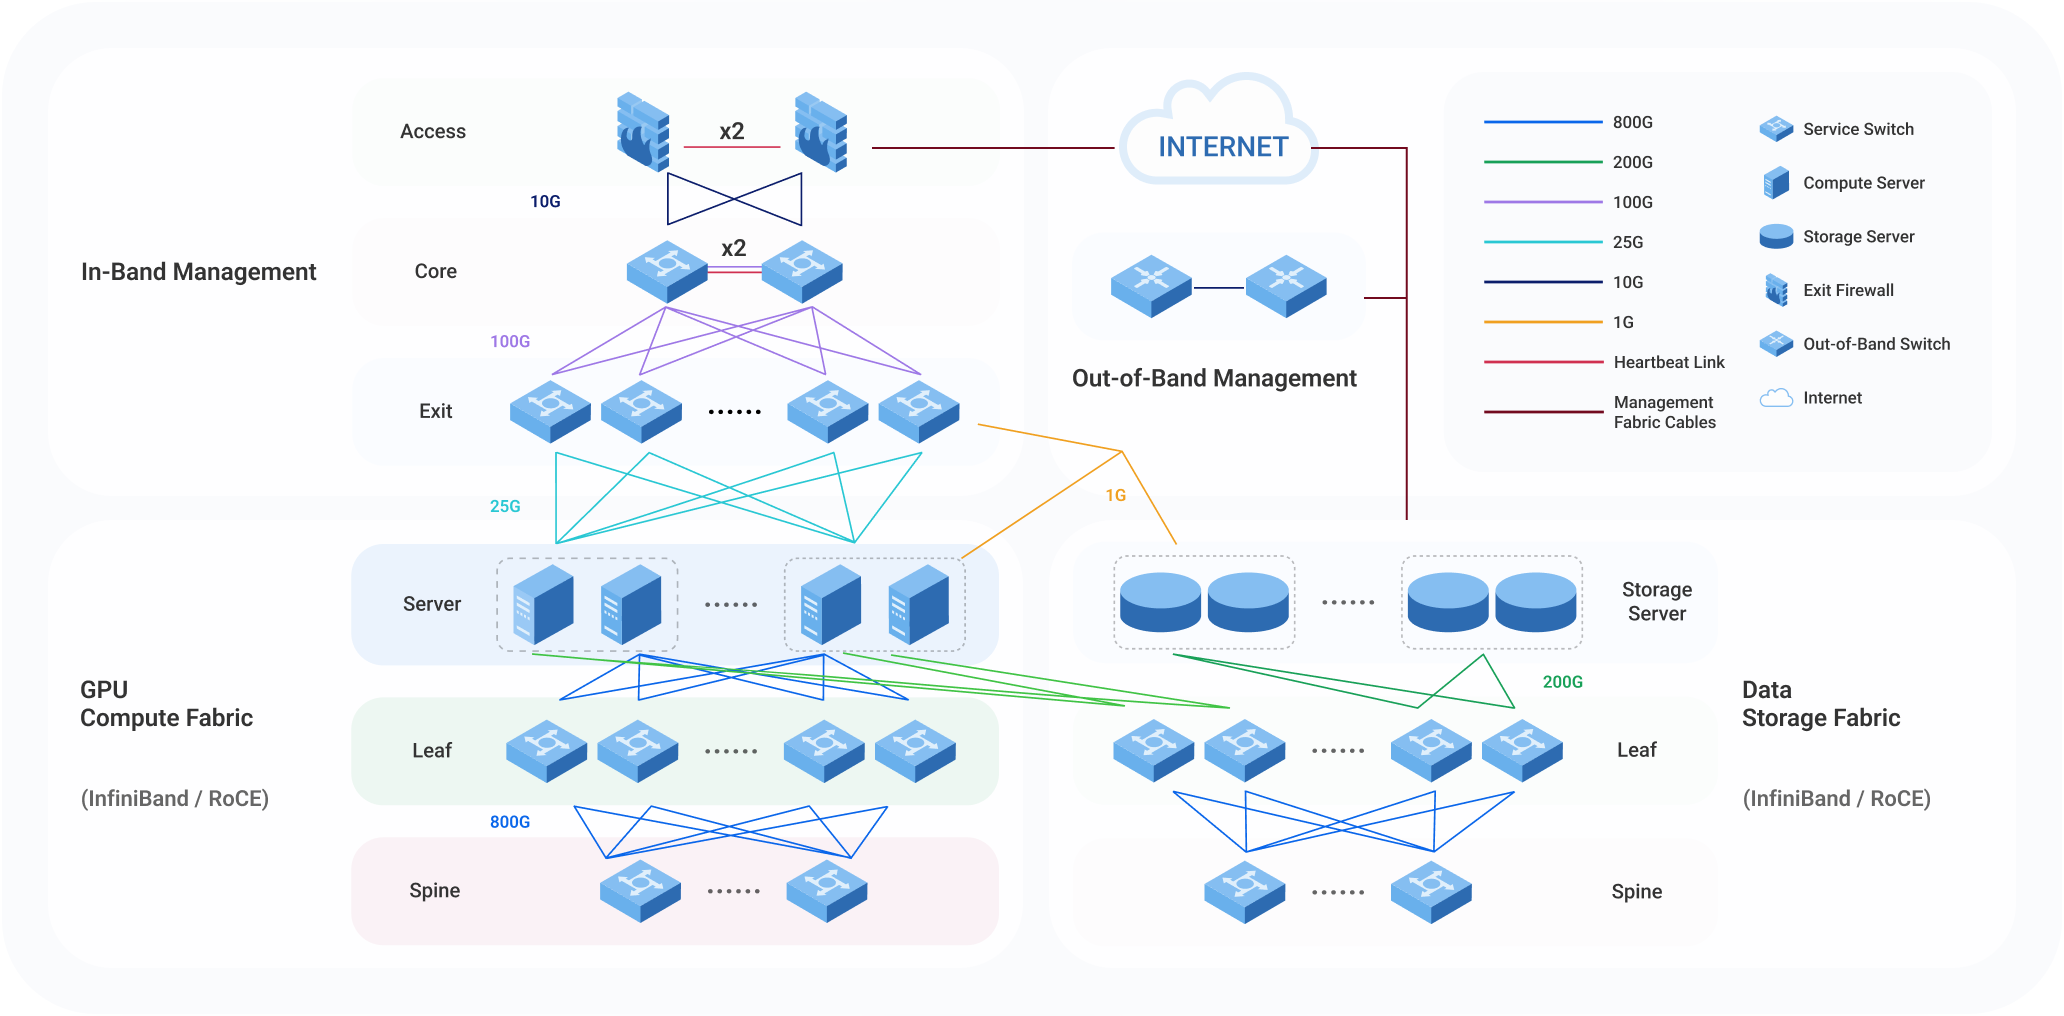
B300 SuperPOD 的计算结构
B300 SuperPOD 支持 InfiniBand 或以太网作为其横向扩展计算网络。两种架构均与 ConnectX-8 配合使用,并可通过高带宽网络实现大规模 GPU 集群扩展。然而,它们在网络技术、交换机生态系统和数据中心基础设施的集成方法方面有所不同。根据GPU集群规模、工作负载类型、网络运维框架、现有数据中心设施等因素进行选择。
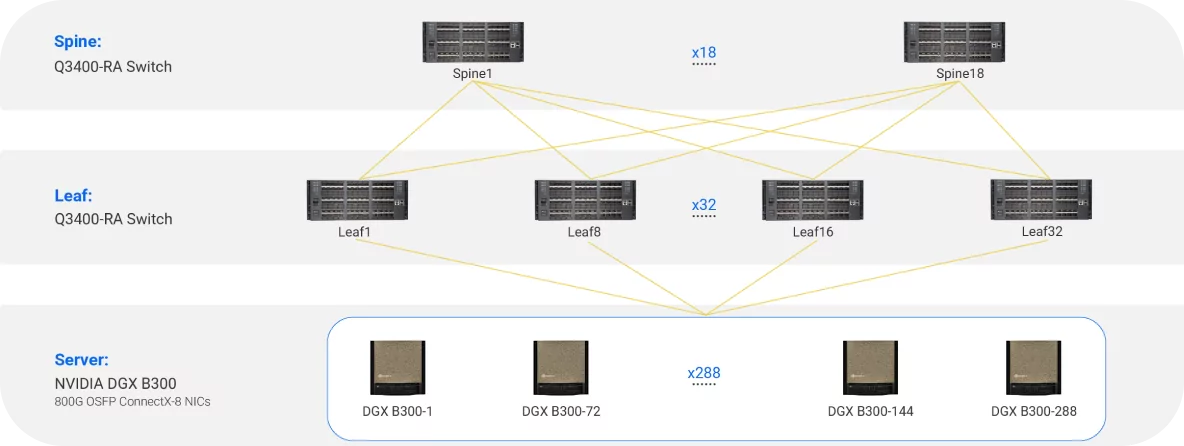
无限带宽
InfiniBand是HPC和AI集群的专用网络架构,提供成熟的端到端高性能结构和强大的AI/HPC网络生态系统。
通过ConnectX-8适配器和Q3400 IB交换机进行单平面组网:ConnectX-8支持800G单端口或400G双端口; Q3400提供144×800G端口。
该解决方案部署在两层 Spine-Leaf 中,最多可扩展至 10,368 个 GPU。超过 10,368 个 GPU 的集群可以使用双平面网络或三层架构进行扩展。
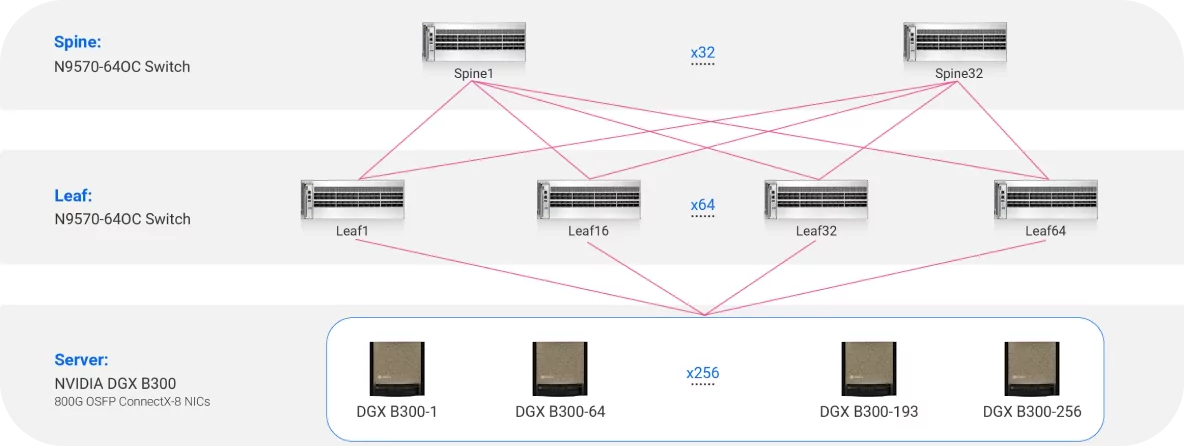
罗CE
RoCE 在标准以太网基础设施上运行,适合将 AI 网络与现有数据中心以太网集成的部署。
在以太网模式下,ConnectX-8适配器不支持单端口800G,最大支持双端口400G。高性能以太网使横向扩展网络具有高可扩展性、有利的TCO和开放的生态系统。
可采用高密度51.2Tbps交换机,提供64×800GbE或128×400GbE端口。与铁路优化网络和多平面架构相结合,它为大规模 GPU 集群提供高性能网络。



SuperPOD关键网络设计
铁路优化网络
Rail-Optimized 拓扑的工作原理如下:在每个系统中,GPU 1 与 NIC 1 配对并连接到交换机 1,GPU 2 与 NIC 2 配对并连接到交换机 2,依此类推。这种设计使得集群中不同系统中具有相同索引的 GPU 之间能够进行单跳通信,最终在大规模 AI 网络中的所有服务器上构建非阻塞的全对全网络结构。
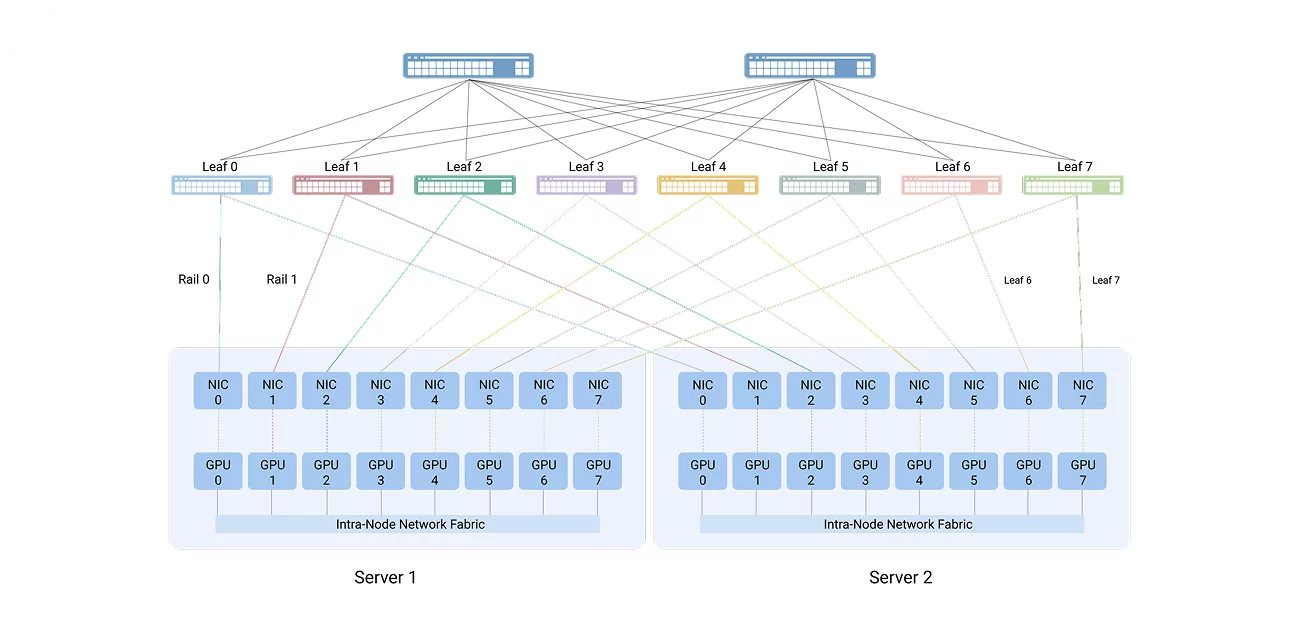
多平面网络
B300解决方案的核心特点是双平面Leaf-Spine设计(平面A和平面B)。基于Rail-Optimized网络,GPU沿轨道排列,如下所示:SU1(GPU-001至064)和SU16(GPU-961至1024)。每个 GPU 通过两个 NVIDIA ConnectX-8 SuperNIC 连接到两个独立平面,每个链路以 400GbE 运行,每个 GPU 总共提供 2×400Gbps。
两个平面物理隔离,骨干层交换机之间建立少量逃生路径。多平面设计不仅为AI训练提供高性能和低延迟,还显著提高了容错能力:当单个交换机、光模块或电缆发生故障时,作业可以以原始带宽的一半继续在独立路径上运行。而且,由于两个平面在核心层是独立的,因此只需要两层Leaf-Spine就可以连接两倍的节点,在保持高性能的同时降低了构建成本。该架构还通过平面负载均衡器和 ConnectX-8 NIC 中内置的软件自动进行流量优化,同时提供实时网络遥测和监控,以确保 AI 工作负载高效可靠的运行。
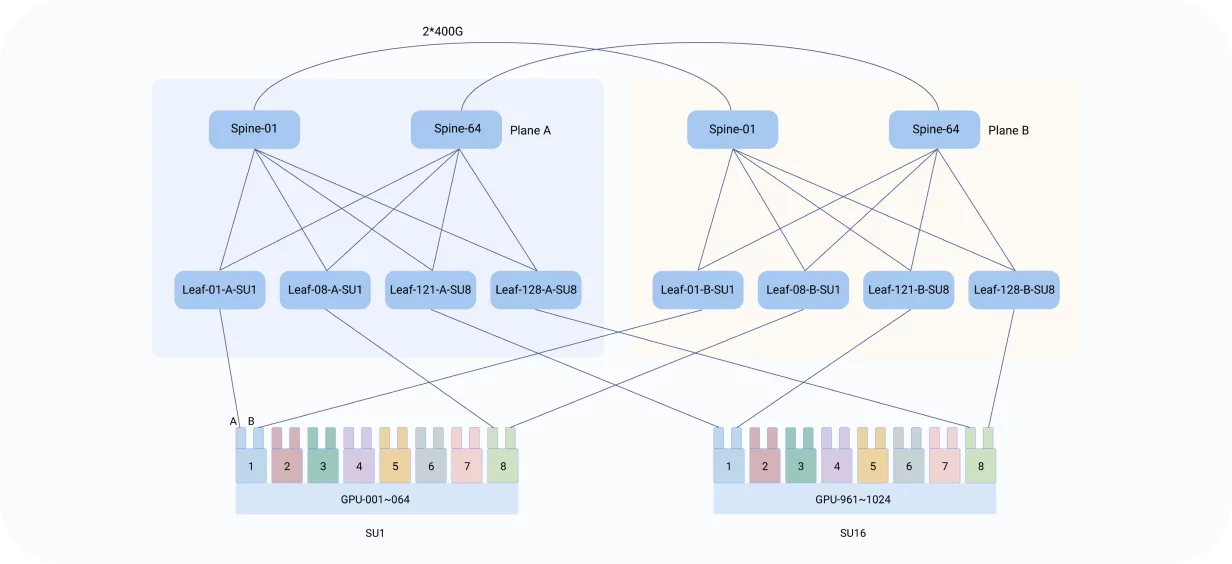
故障隔离实现超高可靠性
每个平面都是一个物理上独立的网络。 A 平面的设备故障或链路中断不会影响 B 平面,消除了单点故障导致整个网络瘫痪的风险。
流量自动故障转移到健康的平面,因此人工智能训练任务几乎不受网络故障的影响——显著提高了集群的整体可用性。

端到端 B300 基础设施可扩展架构
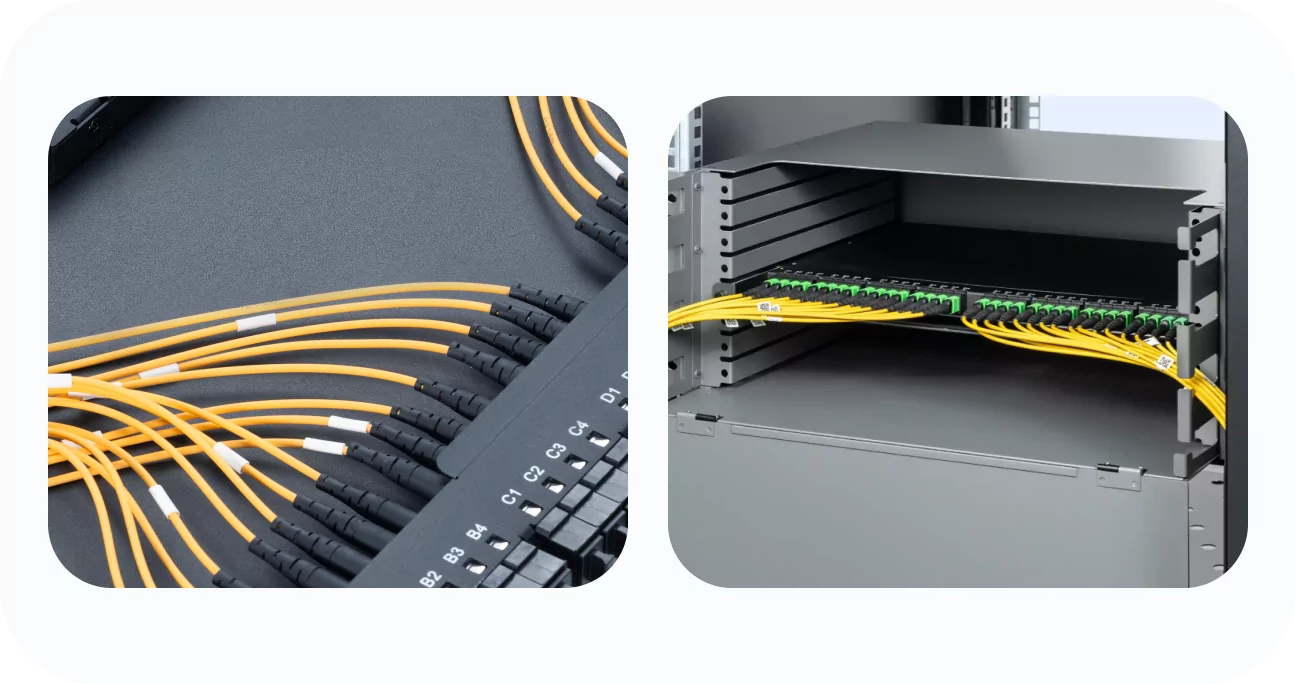
人工智能基础设施的发展从根本上依赖于计算密度和网络拓扑之间的深度协同。通过集成模块化 SU、物理隔离的存储结构和铁路优化的结构化布线,B300 架构实现了计算和带宽的线性扩展,同时保持严格的拓扑和工程一致性,为超大规模 AI 集群建立确定性框架。
从单节点到多 SU SuperPOD,释放峰值系统性能不仅取决于原始计算密度,还取决于物理互连的精确实施。在800G高密度和轨道优化架构下,结构化光混洗系统、高可靠性光光模块和低延迟布线组件作为重要的物理基础,确保下一代人工智能基础设施的无阻塞吞吐量和零丢失性能。
适用于 B300 集群的 Dilight 网络产品组合
| 无限带宽 | 罗CE | |
|---|---|---|
| 脊叶交换机 | ||
| 光模块(交换机侧) | ||
| 光模块(NIC侧) | ||
| DAC/AOC/AEC | ||
| 光纤电缆 |
B300集群部署服务
Dilight为SuperPOD集群提供全栈交钥匙建设能力,独立管理涵盖网络架构设计、拓扑优化、设备部署、高速互连布线、光系统集成和系统调测的端到端交付。
设计
部署
验证
操作
交接
维护
Dilight 工业人工智能解决方案
人工智能基础设施以有形的商业价值为中心。凭借高性能横向扩展网络和专业托管服务,Dilight 提供行业特定的 AI 解决方案,以加速工业智能化。
网络安全
医疗保健和生命科学
全球能源
金融服务