Loading content… / 正在加载内容…
为什么将 RoCE 用于 AI 网络

RoCE 满足多样化的 AI 集群需求
RoCE支持从中型到超大规模的AI集群部署,通过可扩展的以太网架构、灵活的拓扑设计和高效的拥塞控制提供稳定的高性能,同时其开放的生态系统和可路由能力确保网络平滑演进,以满足未来的计算增长和多样化的工作负载。

用于 AI 训练、推理和 HPC 的 RoCE
RoCE网络广泛应用于人工智能训练和推理、机器学习、高性能计算和分布式存储。通过利用 RDMA、无损以太网和硬件卸载,它可以实现 GPU、计算节点和存储系统之间的低延迟、高吞吐量通信。 RoCE 提供接近 InfiniBand 的性能,同时保留以太网的可扩展性和成本效率。

基于 RoCE 的以太网结构的主要优势

减少 CPU 开销并释放计算资源
传统的 TCP/IP 通过中断和内存复制消耗大量 CPU 资源。 RoCEv2 使用内核旁路和工作负载卸载将数据处理从 CPU 转移到支持 RDMA 的 NIC,从而减少开销和延迟。这可以为 AI 工作负载释放 CPU 资源,并实现微秒级性能。

构建无损网络稳定运行
传统以太网在高负载下会出现拥塞和丢包的情况,导致任务失败和计算浪费。 RoCEv2使用PFC(优先级流量控制)来暂停低优先级流量,并使用ECN(显式拥塞通知)来构建无损以太网环境以进行拥塞感知,防止数据包丢失并确保稳定的AI工作负载。
重用现有基础设施并降低成本
高性能网络传统上依赖于 InfiniBand,它涉及昂贵的交换机和 NIC、封闭的生态系统以及专门的运营团队。 RoCE 利用现有以太网基础设施(支持 PFC/ECN),无需大规模网络升级,从而显著降低硬件成本。其开放生态系统可实现 NVIDIA、Arista、Broadcom、Cisco 和其他供应商平台之间的互操作性,从而降低采购和升级成本。
开放 RoCE 生态系统中的光互连
NVIDIA 为 AI 工作负载构建了完全优化的端到端 RoCE 生态系统,涵盖 GPU 计算、NIC、交换机和软件层。
GPU层
用于大规模人工智能训练和推理的高密度计算平台。
网卡层
ConnectX 系列 NIC、以太网 SuperNIC 和 BlueField DPU 可实现 RDMA 加速和高效数据传输。
交换层
Spectrum 以太网交换机提供高吞吐量和无损结构功能。
软件层
统一网络堆栈支持拥塞控制和工作负载优化。
虽然 NVIDIA 定义了端到端系统优化,但 RoCE 网络的实际性能取决于连接每个组件的物理互连层。光互连成为维持系统级性能的关键基础。
在 NVIDIA RoCE 生态系统的光互连层之上,Dilight 通过将光光模块和 AOC/DAC 电缆等关键组件集成到主流 AI 网络架构中,提供端到端互连解决方案,从而在交换机和服务器之间实现高可靠、超低延迟、高带宽的连接。

确保端到端带宽效率

保持GPU集群延迟一致性

保证无损传输的可靠性
适用于 NVIDIA 以太网平台的 Dilight RoCE 解决方案
Dilight高速光互连解决方案针对NVIDIA以太网平台进行了深度优化,针对基于RoCE的AI和HPC部署,并为大规模GPU集群提供关键的物理连接。

深度兼容 NVIDIA ConnectX 系列 NIC/以太网 SuperNIC 和 Spectrum 以太网交换机,支持端到端 RoCE 网络架构。
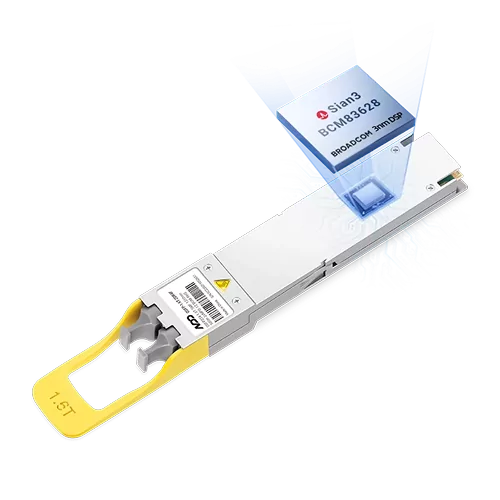
提供全系列400G/800G/1.6T光模块、DAC、AOC,作为服务器和交换机之间的高速物理链路层。
针对 RoCEv2 和 AI 训练流量模式进行设计和验证,确保在基于 Spectrum 的无损以太网环境中可靠运行,并提供低延迟、高吞吐量和长期稳定性。
凭借跨 NVIDIA 以太网平台的强大兼容性,Dilight 有助于为下一代 AI 网络架构构建可扩展的高性能光学互连基础设施。
适用于 NVIDIA DGX Blackwell (B300/B200) 的 800G/400G RoCE 解决方案

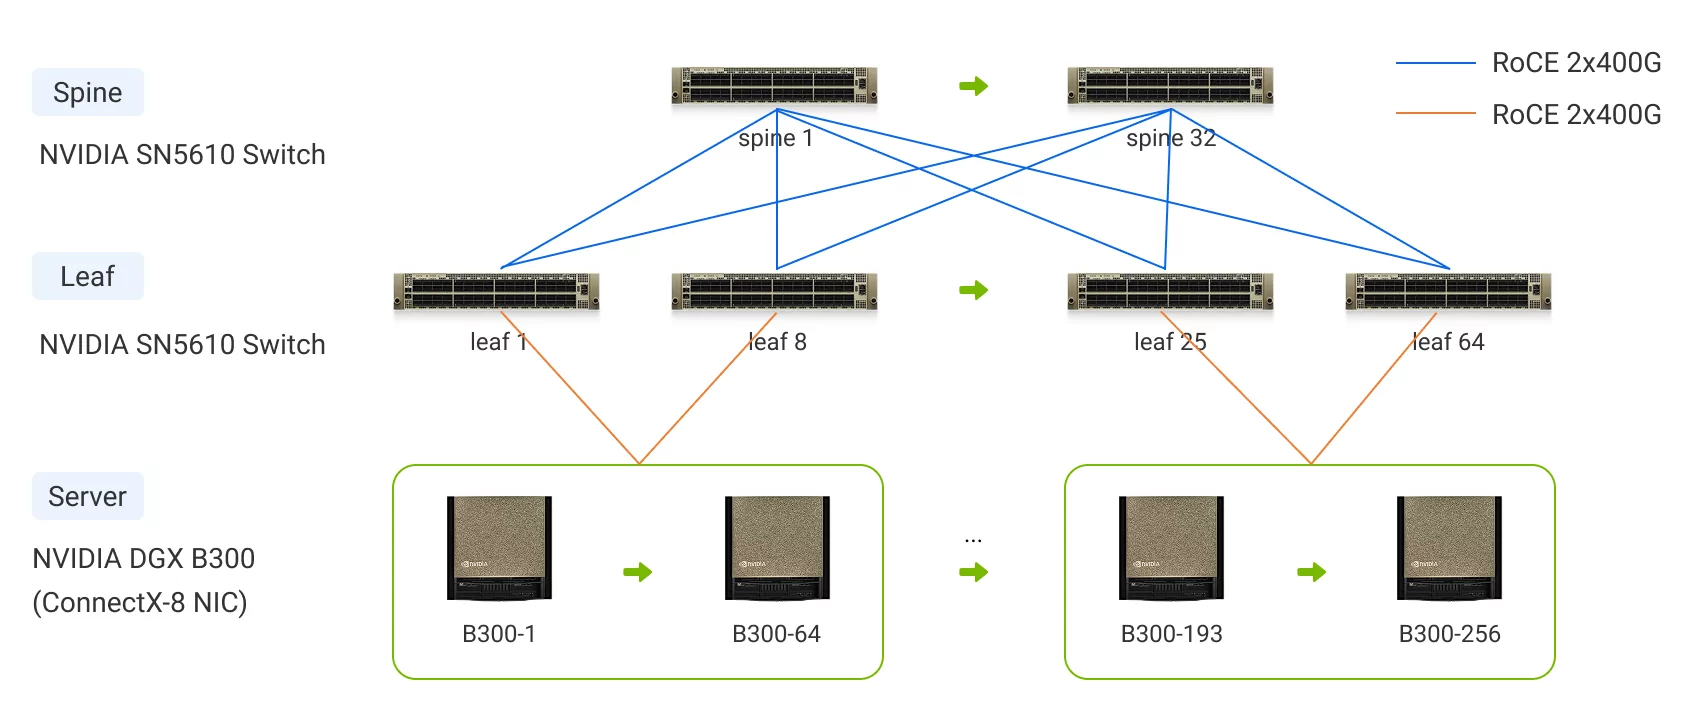
用于可扩展 AI 集群互连的 Dilight 产品
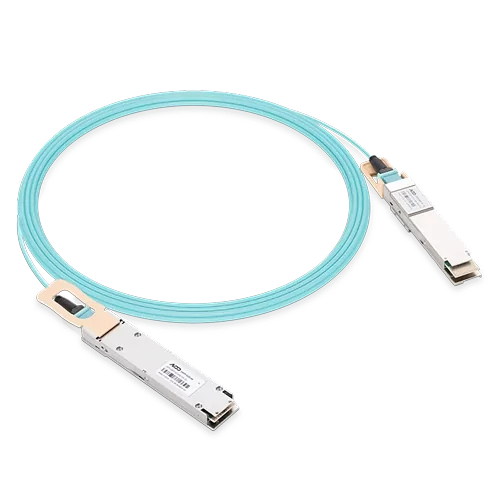
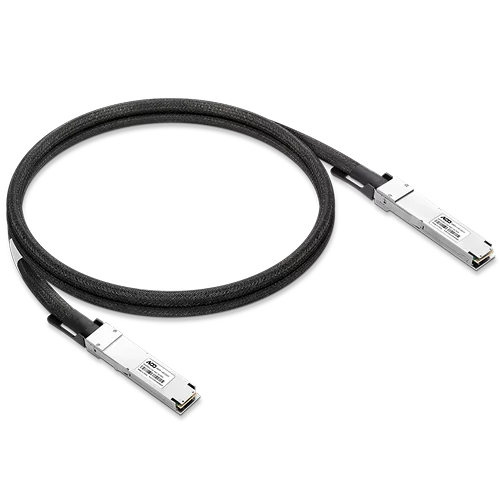
为什么选择 Dilight RoCE 产品?
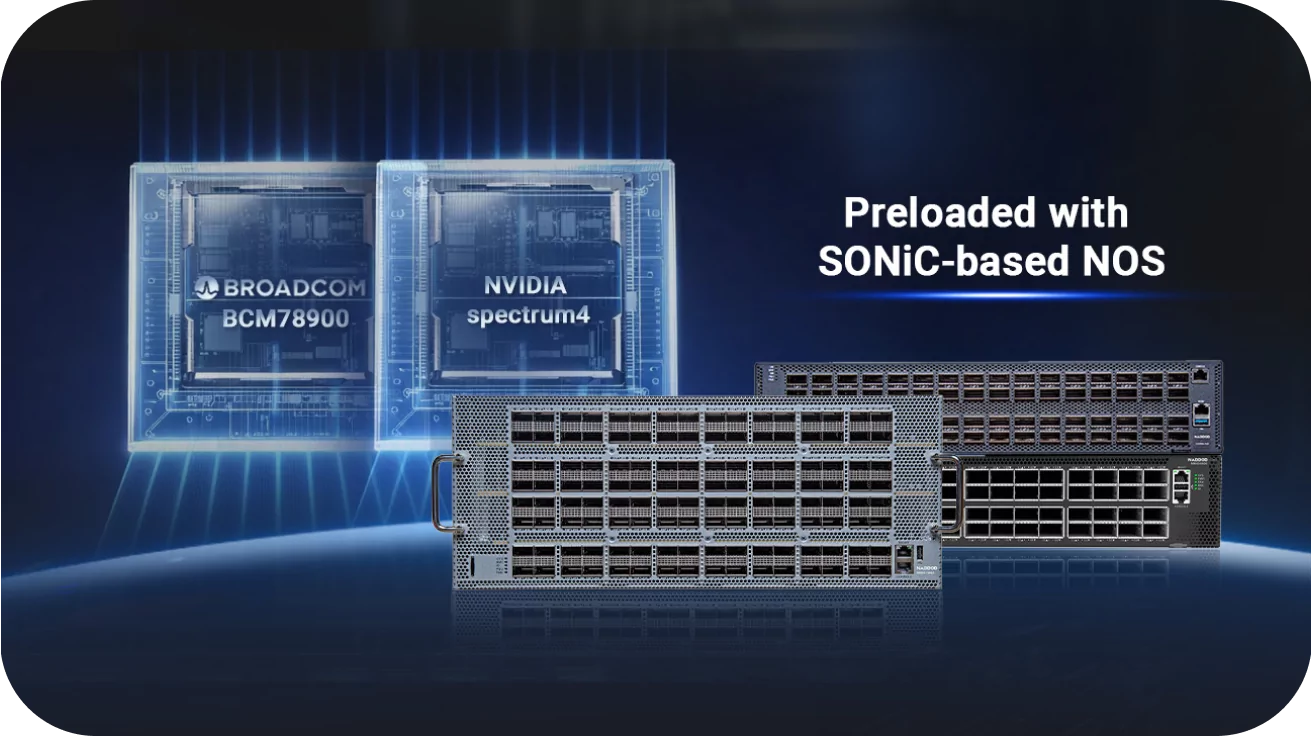
AIDC 的高性能交换机和光学器件
Dilight 的 AI 交换机和光学器件专为在要求苛刻的 AI 环境中发挥最佳性能而设计。我们的 800G/400G 51.2T 交换机,由 Broadcom Tomahawk 5/4 或 NVIDIA Spectrum-4 芯片 并预装SONiC网络操作系统,支持RoCEv2无损组网,具备完整的二三层转发能力。认知路由,例如全局负载平衡、反应式路径重新平衡、硬件链路故障转移和丢弃拥塞通知,可优化网络效率并提高 AI/ML 训练性能。
对于光学,Dilight 集成了 先进的热管理 最大限度地减少人工智能训练集群中网络中断的解决方案。我们的 RoCE 光模块利用尖端 DSP(数字信号处理)和算法调整,实现 FEC 前误码率 (BER) 介于 1E-8 和 1E-10 之间, FEC 后错误几乎为零。这些进步保证了数据中心、AI/ML 集群和 HPC 环境的卓越性能、强大可靠性和无缝连接。
在真实 AIDC 测试环境中经过验证的 RoCE 兼容性
困境 测试中心 基于 NVIDIA、Arista、Broadcom 和 Cisco 等领先供应商的设备构建真实的部署环境,提供跨平台的深度兼容性覆盖 140+ 供应商 生态系统。通过对核心平台(包括 NVIDIA SN5000、Arista 7060X6 和 Cisco Nexus 系列交换机,以及 NVIDIA ConnectX-8 和 Broadcom BCM957608 Thor 2 NIC)的严格验证,Dilight 确保 RoCE 产品通过 100% 互操作性和性能兼容性测试。可根据要求提供详细的测试报告。无论部署在单品牌或多品牌环境中,这种彻底的兼容性测试都可确保平稳的互操作性和高性能。
索取测试报告
100% 在 NVIDIA/Arista/Cisco 等进行测试
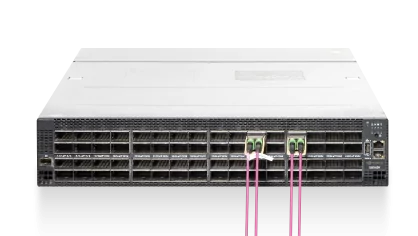
Arista 7060X6/5 系列
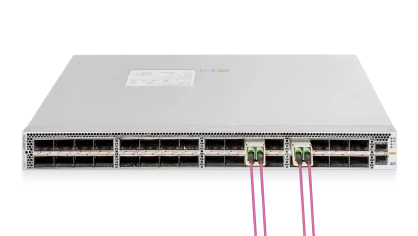
7060X6-64PE7060X6-32PE7060PX5-64E7060DX5-64S7060DX5-32
Cisco Nexus 3400/9300 系列
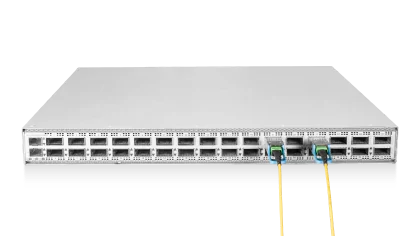
N3K-C3432D-SN9364E-SG2-QN9364E-SG2-O9364D-GX2A9348D-GX2A
RoCE 网络设计和部署能力
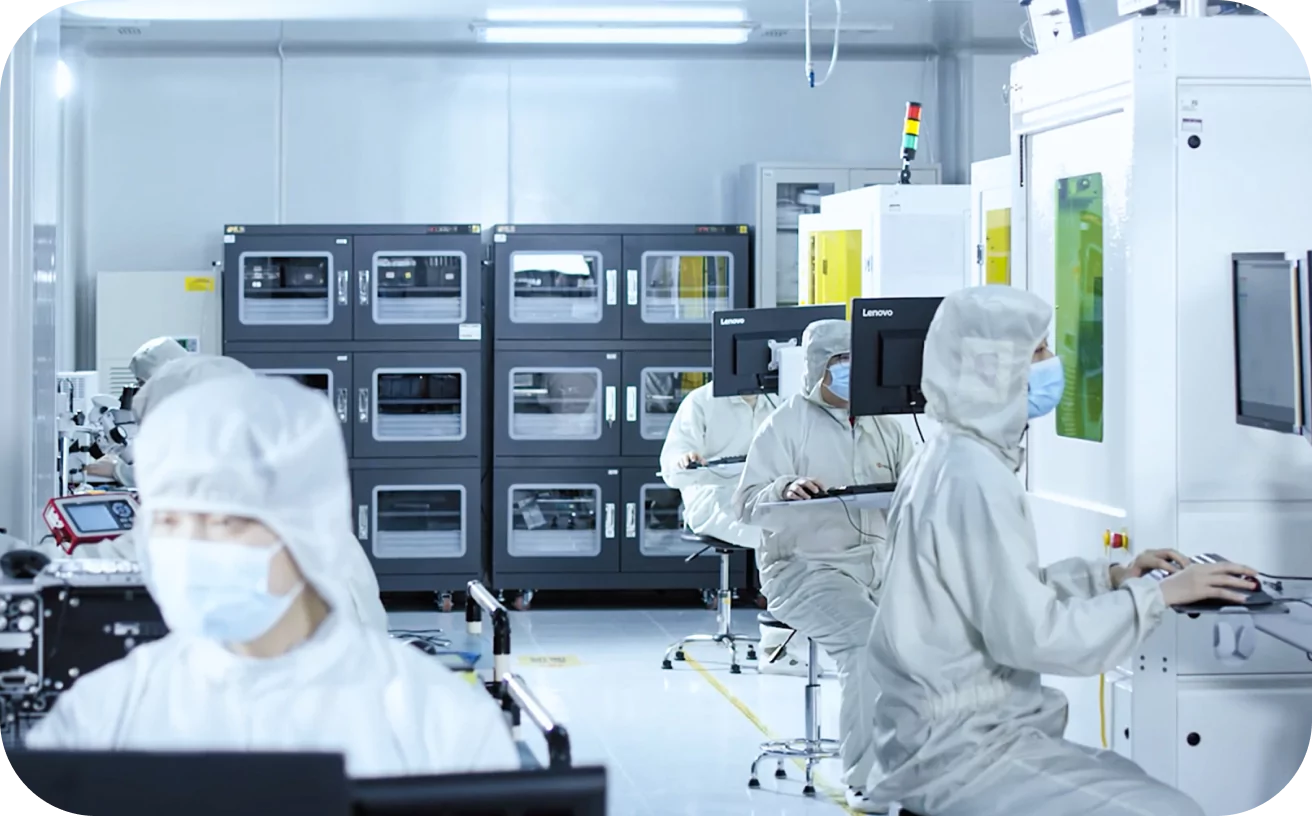
经过验证的 RoCE 网络设计专业知识

Dilight专注于 成熟的 RoCE 互连设计和配置验证,将研发专业知识和大规模部署经验直接嵌入到产品组合中。我们的交换机、光模块、AOC/DAC 电缆和 NIC 针对 AI 和 HPC 工作负载进行了优化,并在多供应商 RoCE 环境中具有经过验证的互操作性。
除了硬件之外,Dilight 还提供经过部署验证的端口配置、速度组合和网络部署解决方案,显著降低网络设计复杂性并最大限度地降低调整和扩展风险。
端到端 RoCE 部署支持
光学器件与设备的兼容性表
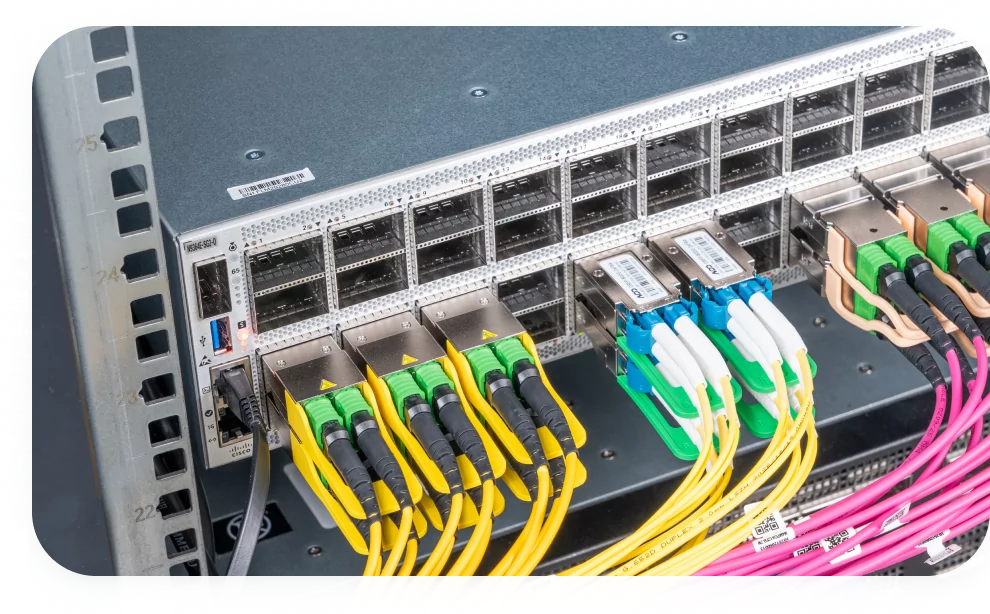
快速识别适合您的网络设备的兼容光模块和布线解决方案。该矩阵基于广泛的多供应商互操作性测试而构建,有助于简化部署并确保跨 AI 数据中心、云和 HPC 网络稳定、经过验证的兼容性。
查看兼容性矩阵
从设计到部署
探索我们的 AIDC服务 提供端到端支持,涵盖人工智能基础设施的设计、部署、优化和交付保证。