Loading content… / 正在加载内容…


- 为什么AI集群需要纵向扩展和横向扩展网络
- 纵向扩展和横向扩展时的不同网络要求
- 纵向扩展和横向扩展可以统一吗?
- 案例研究:NVIDIA NVL72如何实现纵向扩展和横向扩展?
- 纵向扩展和横向扩展人工智能基础设施的未来趋势
- 最后
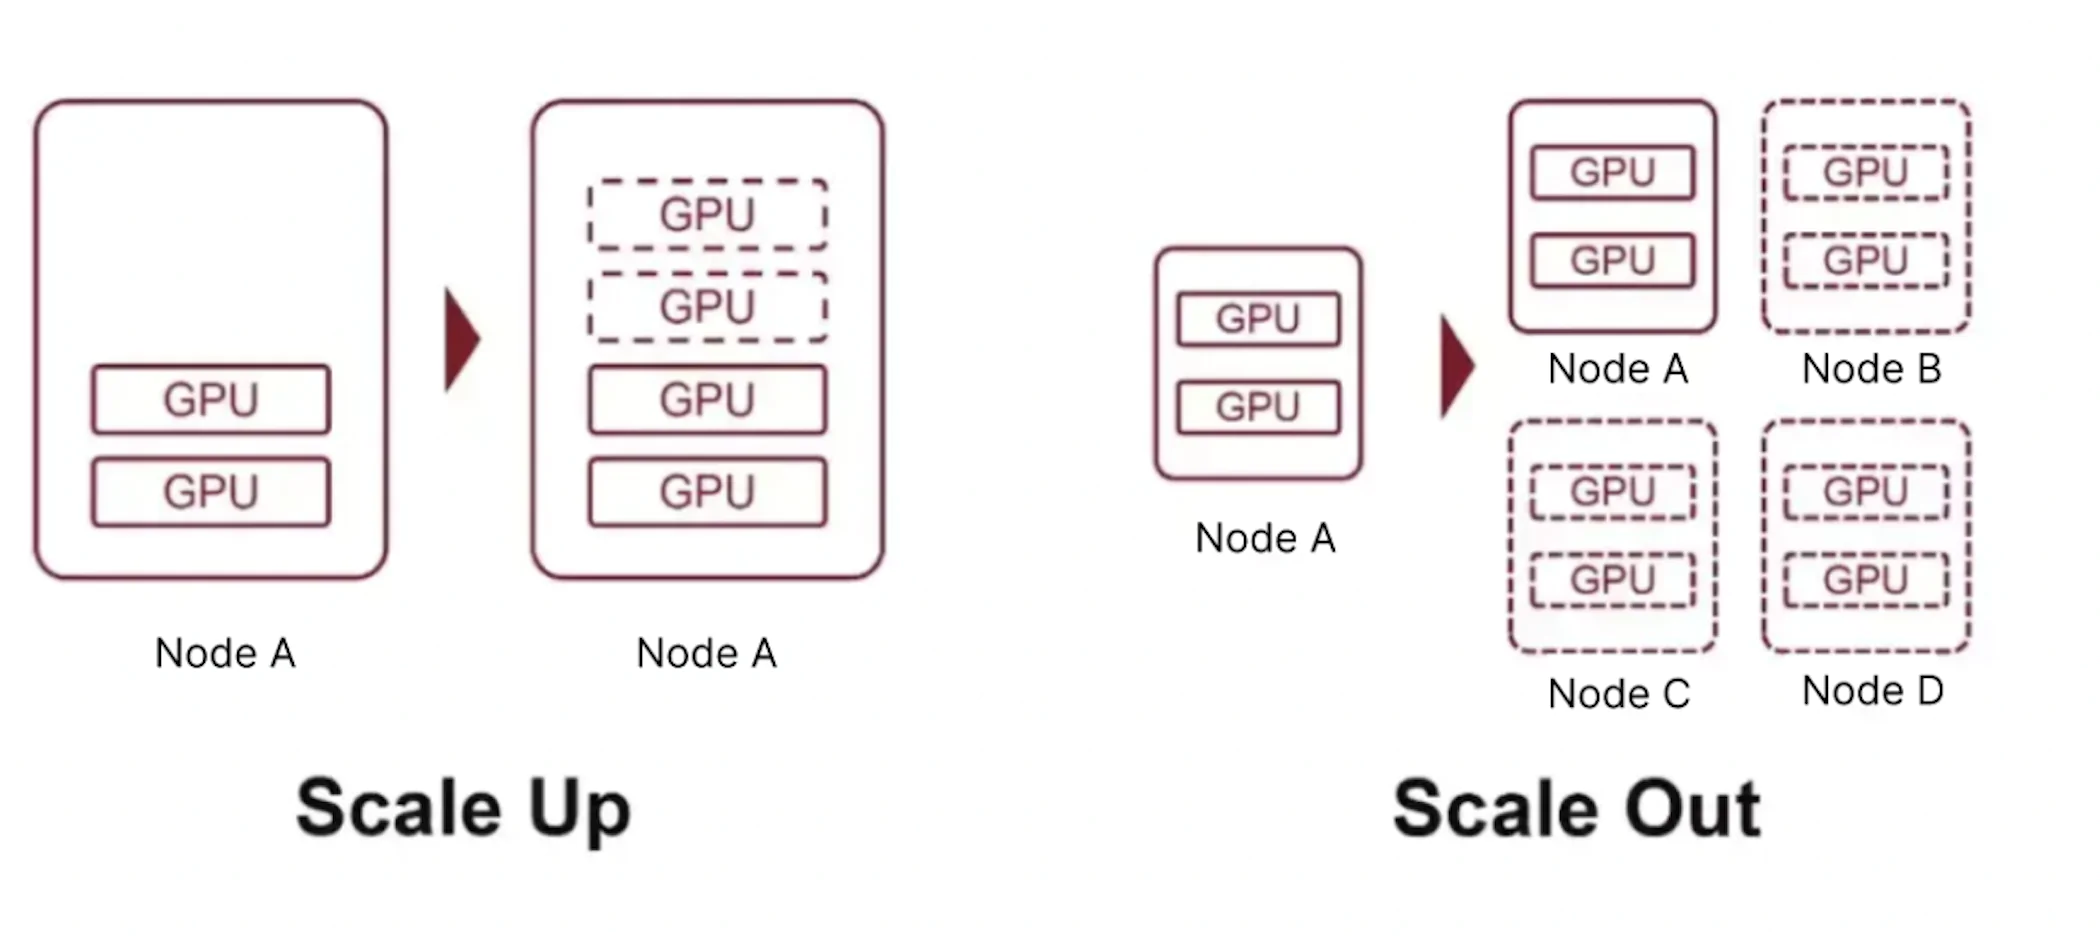
在ICT(信息与通信技术)领域,经常会遇到“规模”的概念。它通常是指增强现有系统的能力以处理更大的工作负载。主要有两种扩展方法:纵向扩展(垂直扩展)和横向扩展(水平扩展)。
放大(垂直缩放):这涉及通过添加更多资源来提高单个系统的性能,例如增加处理器速度、内存或存储容量。从本质上讲,它使一个系统更加强大。
横向扩展(水平扩展):这需要添加更多具有相同或相似配置的系统来分配工作负载。这意味着通过增加并行工作的独立系统的数量来进行扩展。 采用三层/两层Clos架构,可以将数万甚至数十万个GPU连接到统一的集群上,支持DP/PP等并行训练场景。其核心目标是优先考虑规模和管理成本。
网络中的示例:
- 使用基于机箱的交换机并通过添加更多线卡来增加容量代表了纵向扩展模型。
- 使用具有相同端口密度的多个盒式交换机并通过 CLOS 或其他分布式网络架构扩展网络访问代表了 Scale-Out 模型。
在许多情况下,可以结合纵向扩展和横向扩展来构建更大、更高效的网络。
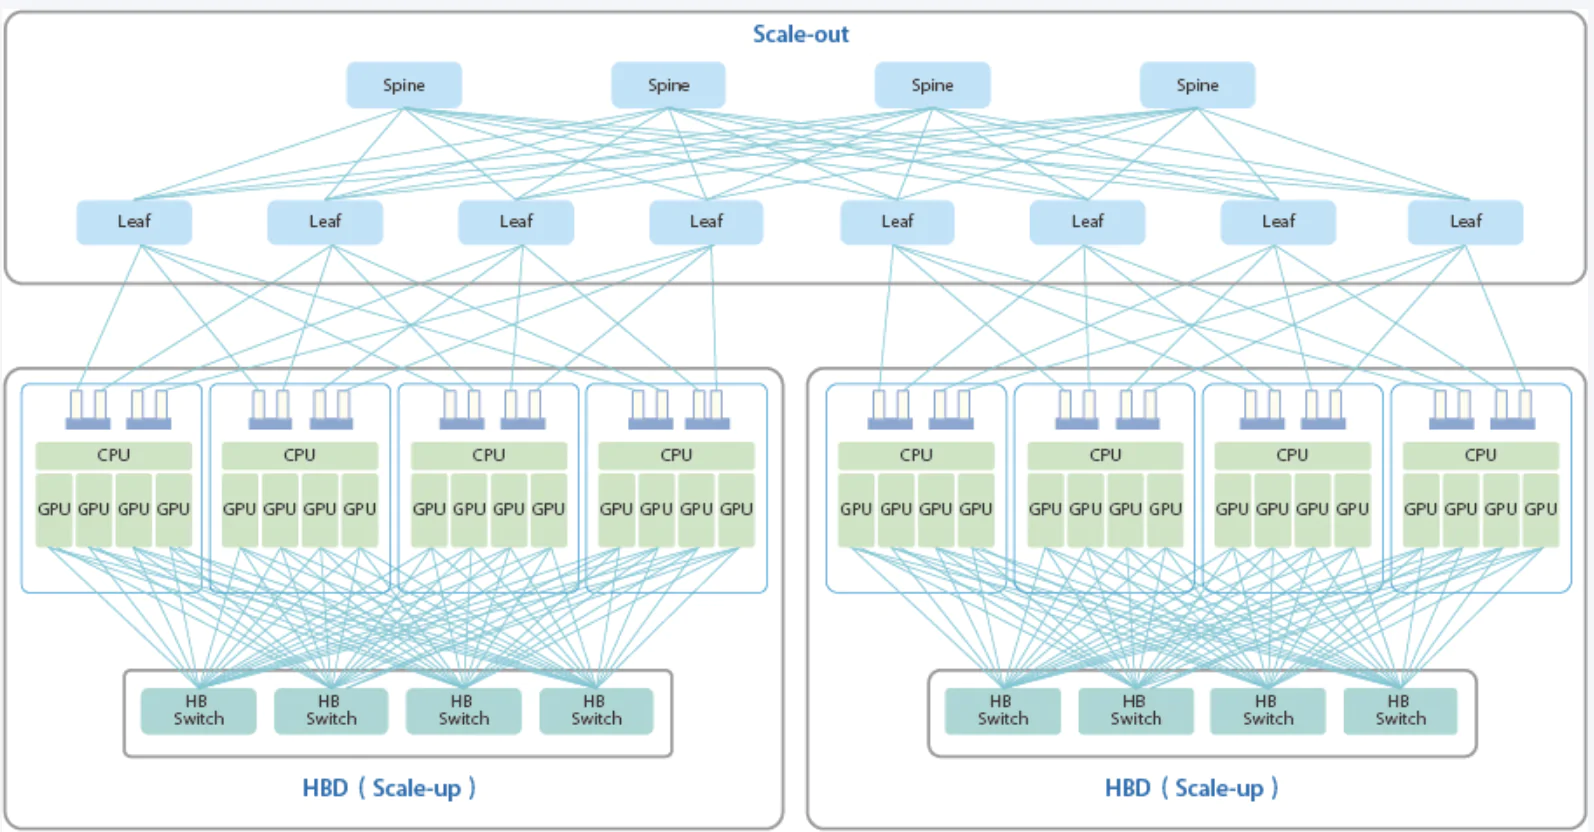
在当今的人工智能计算网络中,纵向扩展和横向扩展网络并存:
- Scale-Up是指GPU之间的高速互连,允许跨GPU内存读/写。
- 横向扩展是指在 GPU 之间启用 RDMA 的网络 (ETH/IB)。
纵向扩展和横向扩展网络之间的协同作用为当今的 AIGC 大型模型提供了动力。
为什么AI集群需要纵向扩展和横向扩展网络
虽然两者都旨在实现 GPU 之间的内存级数据传输,但它们的设计目的和应用场景存在显著差异。 随着大型人工智能模型的兴起,规模不断增长。单个 GPU 服务器已经不够了。并行计算变得必要,这会带来通信开销、分区的复杂性和编程挑战。 Transformer 具有注意力机制和前馈层,对内存和计算资源提出了很高的要求。
理想情况下,人们应该拥有一颗能够单独处理整个大型模型的超级 GPU 芯片。由于这是不可行的,因此模型被分割:
- 高频交互部分(如张量和专家并行)需要高速、低延迟的网络——这就是扩展网络,也称为加载存储或内存语义网络。
- 独立的并行部分(例如管道和数据并行性)可以通过更具成本效益和灵活的方法得到更好的服务 - 这就是横向扩展网络,利用以太网和 RDMA(例如 RoCE)等优化。
虽然 RDMA 在一定程度上模拟了内存访问,但它对于频繁的小内存读/写并不理想,也不是真正的内存语义网络。 这种双网络架构平衡了性能和成本:纵向扩展侧重于最终性能,横向扩展则优先考虑灵活性和经济性。
纵向扩展和横向扩展时的不同网络要求
在大规模模型训练中,两种网络类型都支持 GPU 到 GPU 的数据传输,但它们在延迟方面存在很大差异。
网络延迟是数据通过网络传输所需的时间。它包括:
- 静态延迟:相对恒定,由物理设计和硬件性能决定。
- 动态延迟:可变,受网络负载和带宽利用率的影响。例如,通过 UEC 优化的以太网可以减少动态延迟。
纵向扩展:具有纳秒级延迟的极致性能
这是一个总线域网络,支持直接访问 GPU 内存。由于现代 GPU 的运行速度可以超过 1GHz(每个周期小于 1ns),因此超低延迟至关重要。纵向扩展网络必须实现亚微秒甚至更低的延迟。为了实现这一目标,纵向扩展网络设计必须与特定应用需求紧密结合,消除传统的传输层和网络层,同时采用基于信用的流量控制和链路层重传来确保可靠性。同时,解决高速 SerDes 技术(例如 PAM4 信令和 DSP 架构的 112Gbps/224Gbps 实现)带来的挑战使得确定性延迟控制变得至关重要。现有的 RS(544、514) 前向纠错 (FEC) 方案在这些速度下可能会变得不足,因此需要探索新的 FEC 方法以进一步减少延迟。
横向扩展:毫秒级延迟,更灵活
相比之下,横向扩展网络本质上更加灵活和多样化。它们从 OSI 模型等传统分层网络架构中汲取灵感,这使它们能够支持各种通信和数据传输需求。虽然这种灵活性确实会降低延迟性能,但它也确保网络能够适应更广泛的应用场景。
在横向扩展网络中,端到端延迟通常保持在 1 到 10 毫秒之间,以确保用户感知系统的响应能力。对于AI和HPC环境中的计算密集型任务,虽然超低延迟不是强制性的,但稳定的低延迟仍然是实现高性能的关键因素。横向扩展网络利用现有的工业生态系统(包括交换机和光学模块)并应用 UEC(超以太网联盟)和 GSE(通用流扩展)等性能增强功能来减少动态延迟。然而,由于架构固有的复杂性,静态延迟仍然相对较高。
纵向扩展和横向扩展网络的延迟目标存在显著差异。纵向扩展网络旨在将往返时间 (RTT) 从亚毫秒级降低到亚微秒级,强调极低延迟性能。横向扩展网络优先考虑灵活性和成本效率,提供适合各种工作负载类型的毫秒级延迟。这种延迟性能的区别正是定义了它们在人工智能、高性能计算和其他要求苛刻的计算环境中的不同角色。
为了应对快速增长的人工智能工作负载的挑战,现代横向扩展网络必须支持大规模节点扩展和不可预测的流量爆发。设计时考虑到了这些要求, Dilight 51.2T交换机 N9570-128QC 提供卓越的性能和可扩展性。拥有128个高密度400GE QSFP112端口,支持多达128个GPU服务器互连,并可轻松扩展到数万节点的网络架构。 这款 400G 由 NVIDIA Spectrum-4 芯片提供支持 亚洲开发公司 交换机使用优先流量控制 (PFC) 和显式拥塞通知 (ECN) 来有效管理拥塞并最大限度地减少动态延迟。此外,它还支持自适应路由 (AR),从而实现跨多路径网络的智能数据包级负载平衡。 解决了ECMP固有的静态负载分布不均匀的问题,有效提高了链路利用率。
纵向扩展和横向扩展可以统一吗?
由于设计、目标和实现的根本差异,合并纵向扩展和横向扩展网络是不切实际的。
横向扩展网络植根于传统数据中心,连接地理上分散的节点,以实现高效、长距离的通信。它们擅长远程传输、异构设备互连和多样化的业务通信。纵向扩展网络是一种较新的范例,可通过提高单设备性能来增强系统功能。这些紧密集成的网络将资源整合在有限的物理空间内,以显著提高性能,并且它们与业务逻辑深度耦合。
AI、AGI时代,智能计算网络需求不断上升。简单地增强传统数据中心网络的负载存储能力或尝试使用负载存储技术来扩展网络并不能满足网络规模扩展的需求。它们最初的设计前提不同,导致技术实现、性能和成本效益方面存在显著差异。
从业务逻辑的角度来看,纵向扩展网络(如 NVLink)与加载存储语义保持一致,强调直接、高速内存访问。相比之下,横向扩展网络(如 InfiniBand)基于消息语义,优先考虑灵活性和可扩展性。虽然某些技术规范可能看起来相似,但这仅仅是巧合,并不表明它们具有融合或互换性的潜力。
因此,由于技术理念、应用目标、业务逻辑等方面的固有差异,Scale-Out和Scale-Up网络不应该结合在一起。每个都在其特定领域发挥着不可或缺的作用,共同推动计算网络技术的发展。
案例分析:NVIDIA NVL72如何实现纵向扩展和横向扩展?
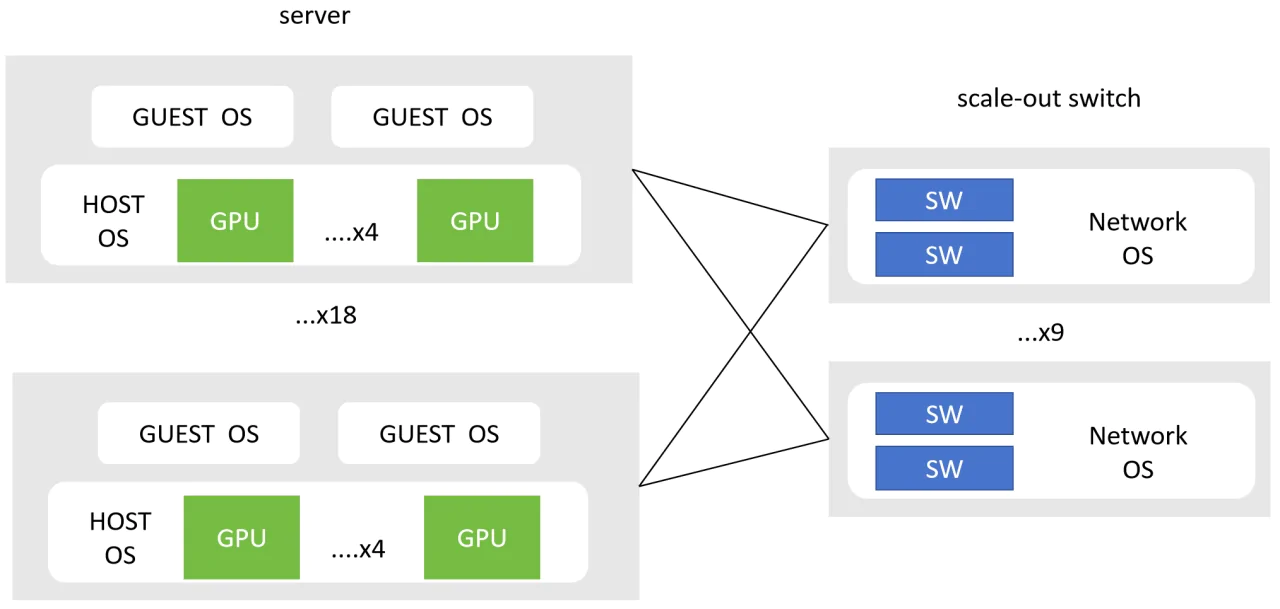
2024 年 3 月,NVIDIA 推出了 GB200 NVL72 超级节点,将 36 个 Grace CPU 和 72 个 Blackwell GPU 集成到单个液冷机柜中。该系统可提供高达 720 PFLOP 的 AI 训练性能或 1440 PFLOP 的推理性能。其架构不仅克服了H100/GH200等前代产品中出现的节点间带宽瓶颈,而且结合了“GPU-GPU NVLink Scale-Up”和“Node-to-Node RDMA Scale-Out”,为EB级数据处理和万亿参数模型训练提供可扩展的基础设施。
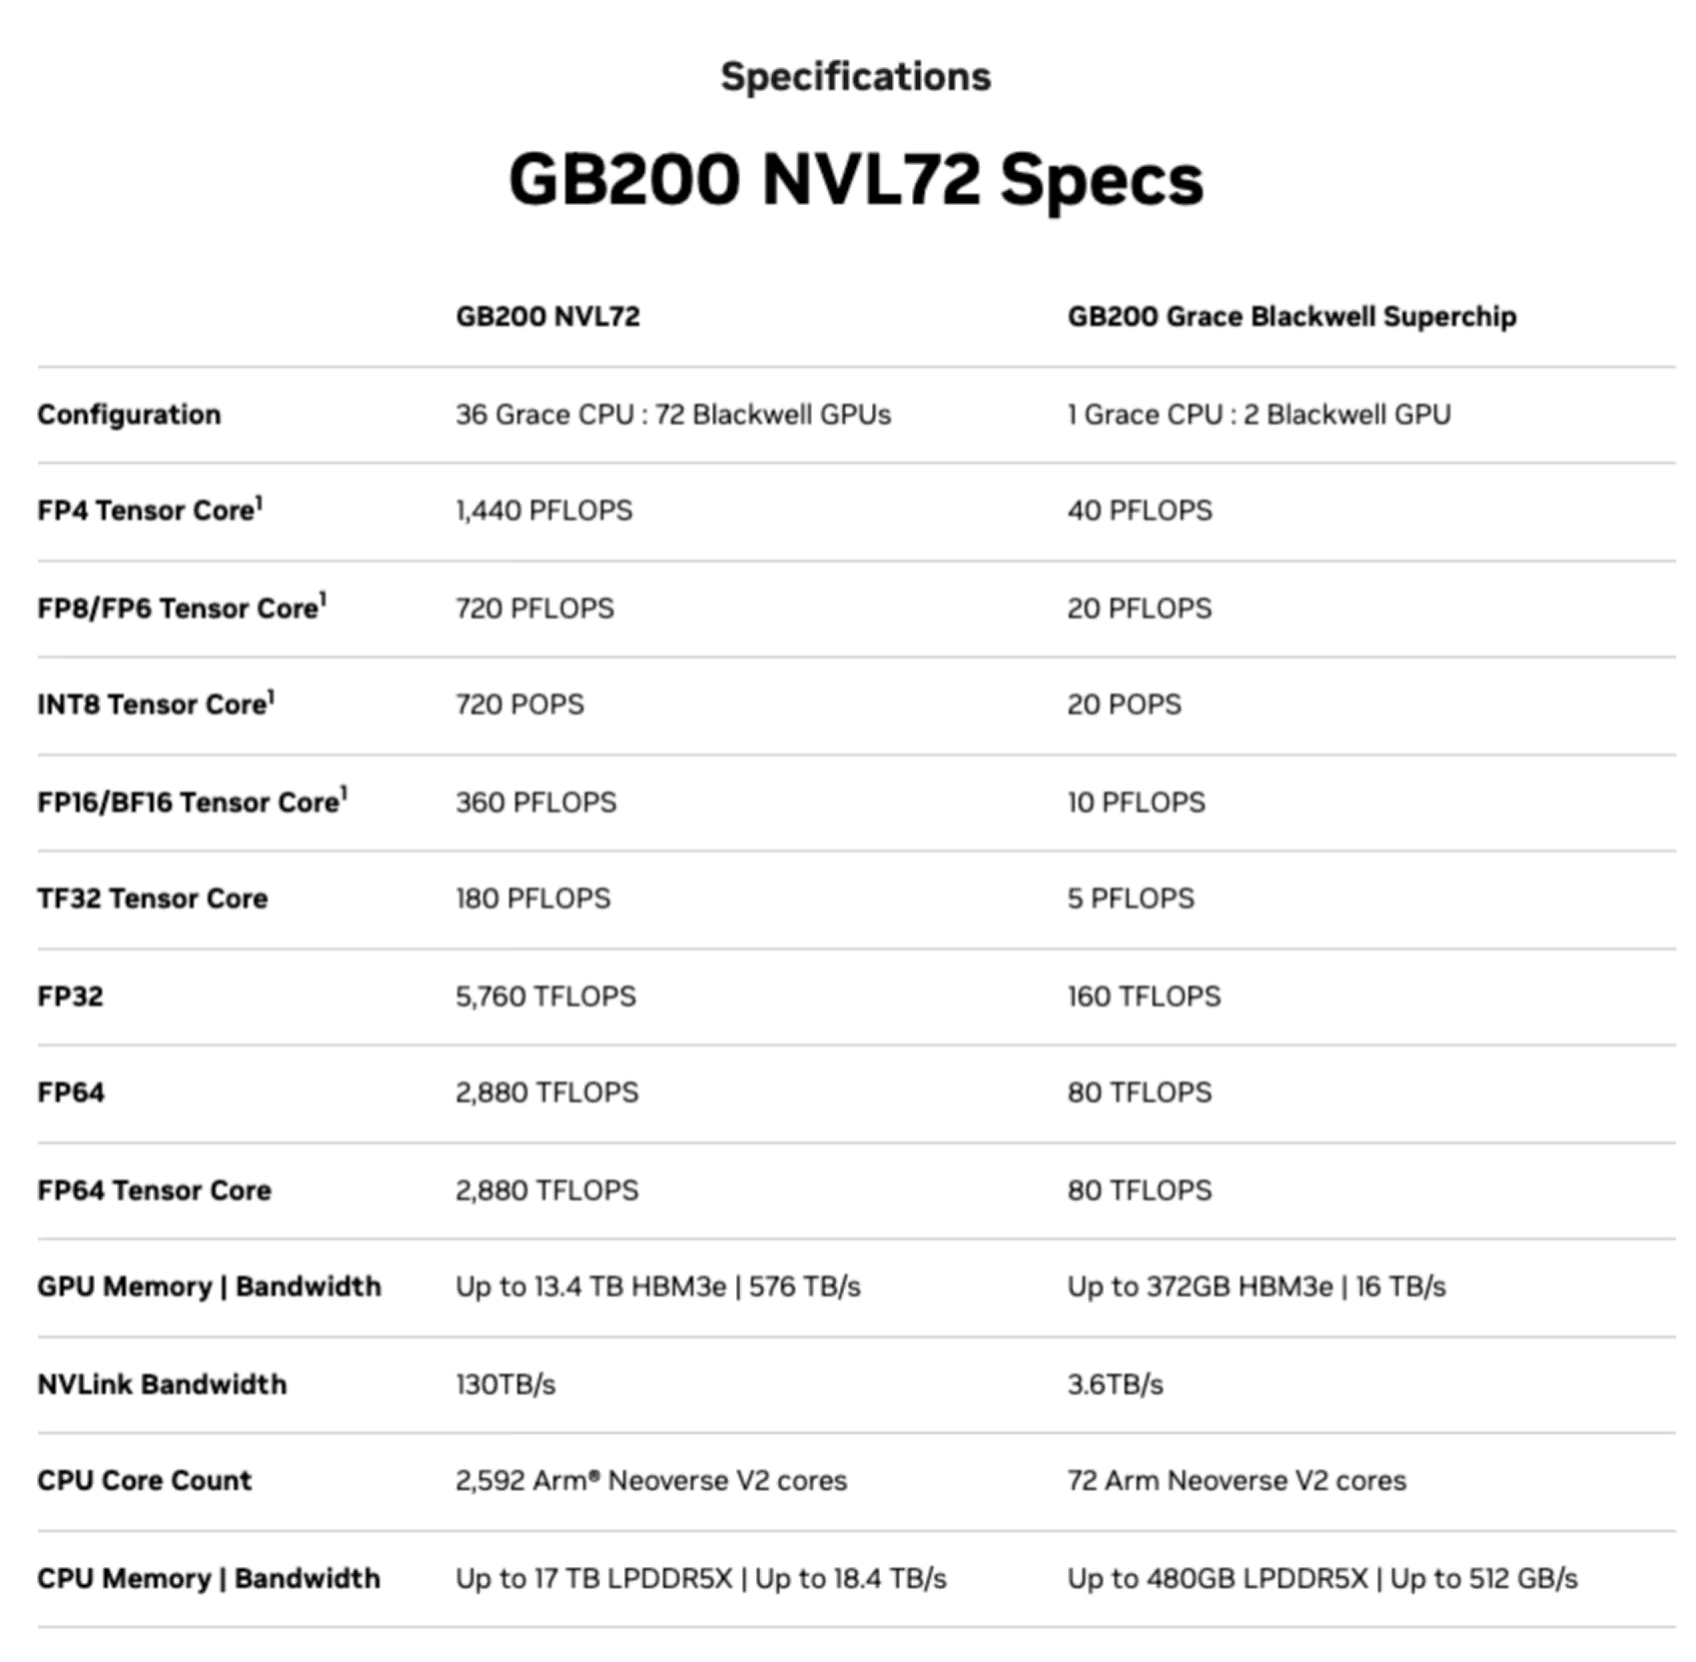
1. 扩展网络互连
在 SuperNode 机柜内,分布在 18 个计算托盘中的 72 个 B200 GPU 通过 NVLink 5 和铜缆完全互连,连接到分布在 9 个交换机托盘中的 18 个 NVSwitch 芯片。
理论带宽:
- 每个 B200 GPU 支持 1.8 TB/s 双向带宽。
- 每个计算托盘(4 个 GPU)提供 7.2 TB/s 的总带宽。
- 所有计算托盘共同提供 129.6 TB/s 的双向带宽。
- 每个 NVLink 交换机以 7.2 TB/s 的速度连接到 4 个 GPU。
- 一个交换层以 14.4 TB/s 的速度连接 8 个 GPU。
- 所有 9 个交换机托盘一起连接 72 个 GPU,总带宽为 129.6 TB/s。
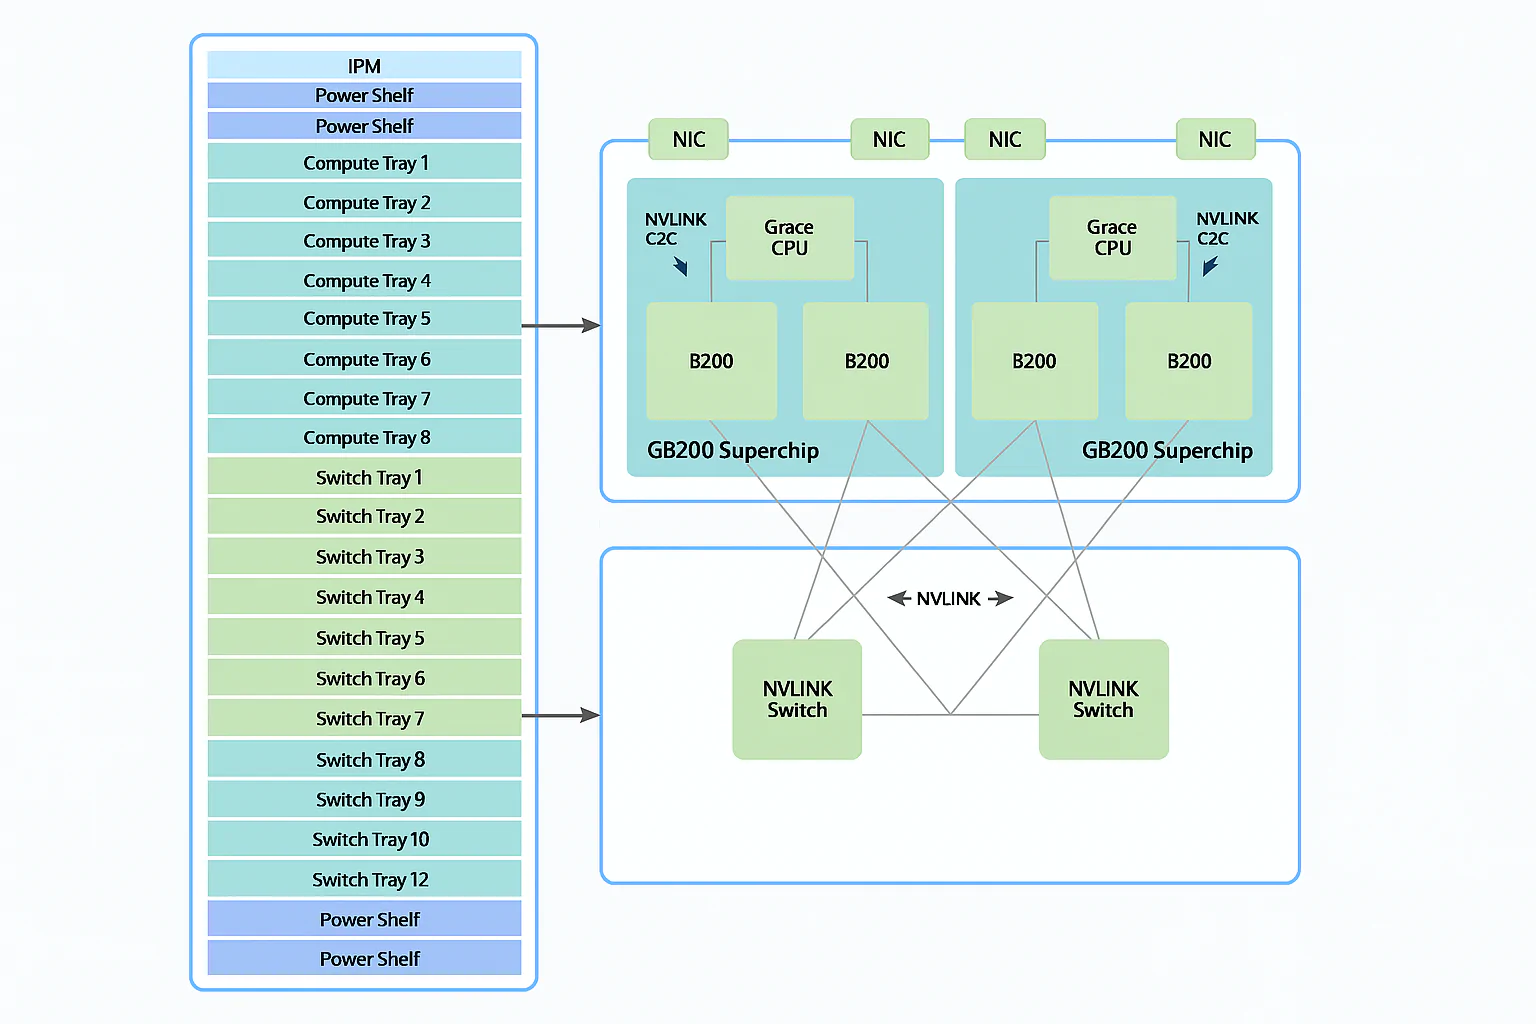
物理布线:
- 每个 B200 GPU 支持 18 个 NVLink 连接到 18 个 NVSwitch 芯片,实现跨 72 个 GPU 的全网状拓扑。
- 每个计算托盘(4 个 GPU)需要 72 个差分对。
- 所有 18 个计算托盘总共需要 5184 个差分对。
- 每个差分对一根电缆意味着整个机柜有 5184 根铜电缆。
布线介质:
该系统使用电缆盒方法(基于铜的互连)。在短距离传输场景中,相比光模块,铜缆具有更高的可靠性和更低的成本,并简化了布线。因此,直接铜连接已成为向上扩展互连的主流解决方案。
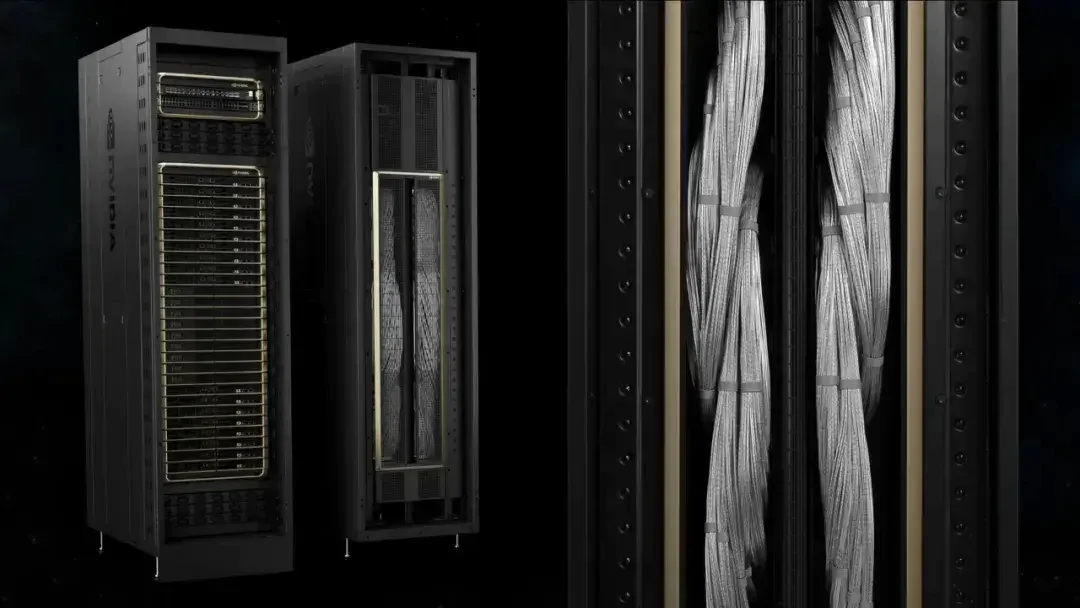
简而言之,NVL72 创建了一个大规模的 Scale-Up 网络,可实现 GPU 之间的高带宽、低延迟通信。
2. 横向扩展网络互连
横向扩展允许将八个 DGX GB200 NVL72 单元集成到具有 576 个 B200 GPU 的 SuperPOD 中。每个计算托盘的四个 GPU 均配备了 CX8 800Gbps RNIC (RDMA NIC),将它们连接到基于 InfiniBand RDMA 的横向扩展网络。
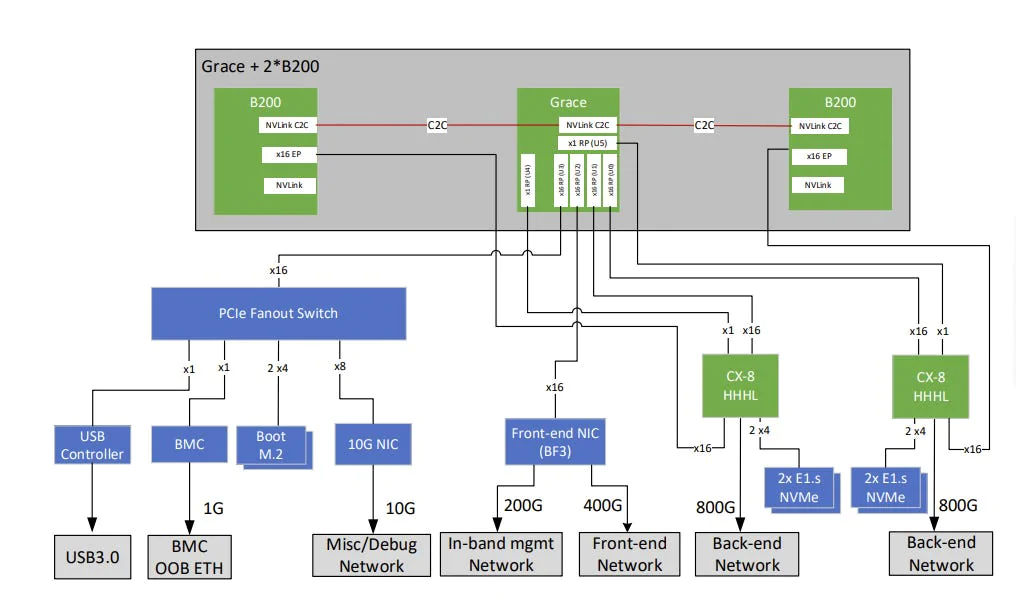
3. NVL72 中的纵向扩展与横向扩展
NVL72 的纵向扩展互连提供:
- 高带宽:每个计算托盘通过 NVLink/NVSwitch 提供 7.2 TB/s 的速度。相比之下,横向扩展连接仅提供 0.4 TB/s (4 × 800Gbps),使横向扩展带宽提高了 18 倍。
- 低延迟:铜缆消除了光学模块的 CDR 或 DSP 通常引入的近 100 纳秒的延迟,同时还降低了成本。
- 大容量统一内存:通过NVLink和NVLink-C2C,机柜中的所有GPU都可以访问彼此的HBM内存以及Grace CPU的DDR内存,总计13.5TB HBM和17TB LPDDR5X系统内存。
纵向扩展和横向扩展人工智能基础设施的未来趋势
网络架构演进
在Scale-Up方面,传统上该行业由机箱超级节点主导,例如NVIDIA NVL72和华为CloudMatrix384。这些架构强调可靠性,通过“电缆背板+L1/L2交换机”的设计构建稳定的互连域。机箱内使用电气互连来实现高带宽,而机柜之间使用光学互连。
然而2025年后盒子超级节点的出现打破了这一格局。 Box SuperNodes通过将多个GPU封装到独立的盒子中并通过一级Clos交换机直接互连,显著减少了交换层数并降低了互连成本。同时,该架构对首跳光连接和系统可靠性提出了更高的要求。
在横向扩展方面,主导趋势是简化。传统的三层 Clos 架构正在通过更扁平的设计方法逐渐被两层 Clos 网络所取代。交换机芯片的进步使得 Radix=512 成为可能,允许两层 Clos 网络直接支持超过 130,000 个 GPU,而不需要专用的核心层。 同时, 多平面网络 正在获得关注。 DeepSeek在其ISCA论文中提出了“多平面架构”:AI-NIC通过4个200G端口接入4个Clos平面,每个流的数据包通过Round-Robin均匀分布到不同平面。接收端采用DDP乱序写入技术对数据进行重组,将单GPU Scale-Out带宽利用率提升至95%以上。
这些趋势共同表明,纵向扩展架构正变得更加灵活,而横向扩展网络正变得更加扁平且更具可扩展性。
光互连的演变
Scale-Up追求超低延迟和低功耗,使得去掉DSP芯片的LPO/NPO光模块成为首选解决方案。 800G LPO光模块功耗仅为6W,比带有DSP的15W光模块低60%。通过消除 DSP 的信号处理,它们将单向延迟减少了 60 纳秒,将往返延迟减少了 240 纳秒。例如, Dilight 的 800G LPO 光模块 针对 AI 数据中心进行了优化,满足 Scale-Up 架构的低功耗和延迟要求。
Scale-Out对跨厂商互操作性和长距离传输的需求使得基于DSP的光模块难以被取代。
误码率优势: 带 DSP 的 DPO 光模块支持复杂的 FEC(前向纠错)算法,实现高达 1E-15 的校正 BER。但LPO的误码率仅为1E-12~1E-13,无法满足Scale-Out长距离(10km+)传输的可靠性要求。 无论是DPO还是LPO模块,当部署在实际生产环境中时,可靠性不仅取决于实验室测试的BER性能,还取决于系统级稳定性和长期运行的鲁棒性,这就是 为什么“通过测试”并不一定意味着基础设施已准备好投入生产.
跨供应商互操作性是必须的: 横向扩展集群通常使用来自多个供应商的设备。 LPO/NPO互操作性尚未达到统一标准。然而,基于 IEEE 802.3 协议的 DPO 光模块可实现无缝互操作性。
至此,光模块的技术划分就明确了:Scale-Up选择LPO/NPO,Scale-Out选择DPO/LRO。虽然这两种技术有所不同,但它们都有一个共同的核心目标:实现“224G 光互联速率”。顺应这一趋势,业界已经开始开发相关产品。例如,Dilight的 OSFP-1.6T-2xDR4 和 OSFP-1.6T-2xFR4 支持未来超级节点架构的高带宽、低时延需求,为数据中心迈向下一阶段的Scale-Up奠定基础。
最后
大规模人工智能模型不断增长,似乎没有限制,并对计算基础设施提出了前所未有的要求。使用 Scale-Up 策略构建超强大的超级节点,然后通过 Scale-Out 跨集群扩展,已成为常见且高效的做法。这种分层方法不仅满足了现代人工智能的性能和可扩展性需求,而且为未来的创新奠定了实践基础。
作为专门的提供商 人工智能网络解决方案,Dilight 利用深厚的技术专业知识和优质的产品(包括 光光模块, AOC/DAC 电缆, 交换机和 NIC等...)帮助客户构建先进的人工智能计算基础设施。从可扩展的网络架构到精确的光学互连,我们提供人工智能时代所需的苛刻性能、可靠性和可扩展性。 伸出手 探索我们如何支持您的智能计算网络。
热门文章
相关产品:
NVIDIA/Mellanox MFP7E10-N020 兼容 20m (66ft) MPO-12 APC(母头)至 MPO-12 APC(母头)12 芯多模 (OM4) 跳线,B 型,LSZH,3.0mm,最大 IL ≤ 0.35dB,洋红色
US$ 55.00
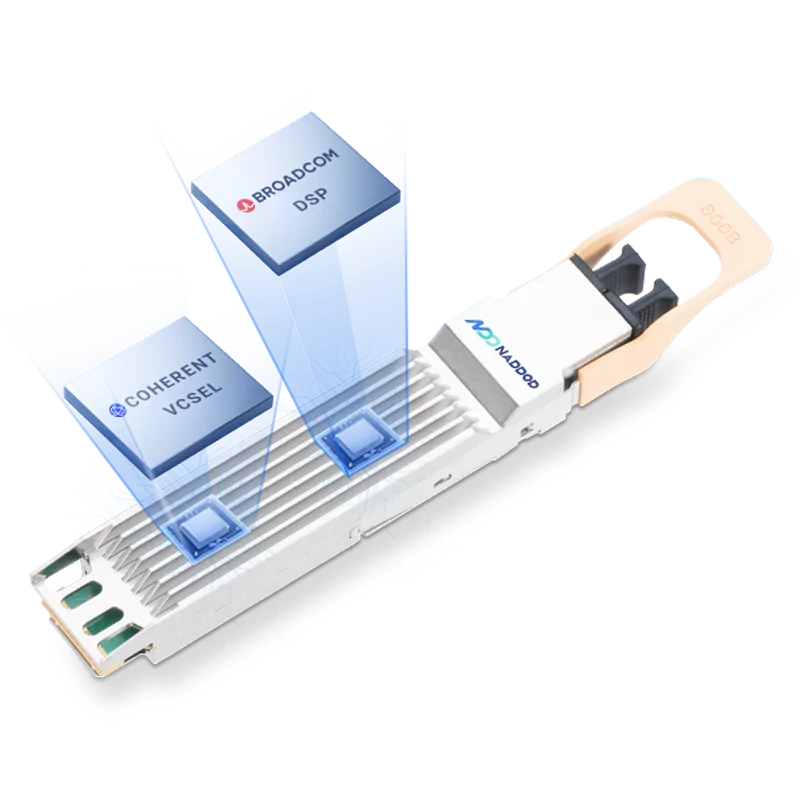
NVIDIA/Mellanox MMA4Z00-NS (980-9I510-00NS00) 兼容 800G 2xSR4 OSFP IHS/Finned Top 8x100G PAM4 Broadcom DSP 和 Broadcom VCSEL 850nm 50m MMF DOM 双 MPO-12/APC InfiniBand NDR 光光模块模块
US$ 699.00
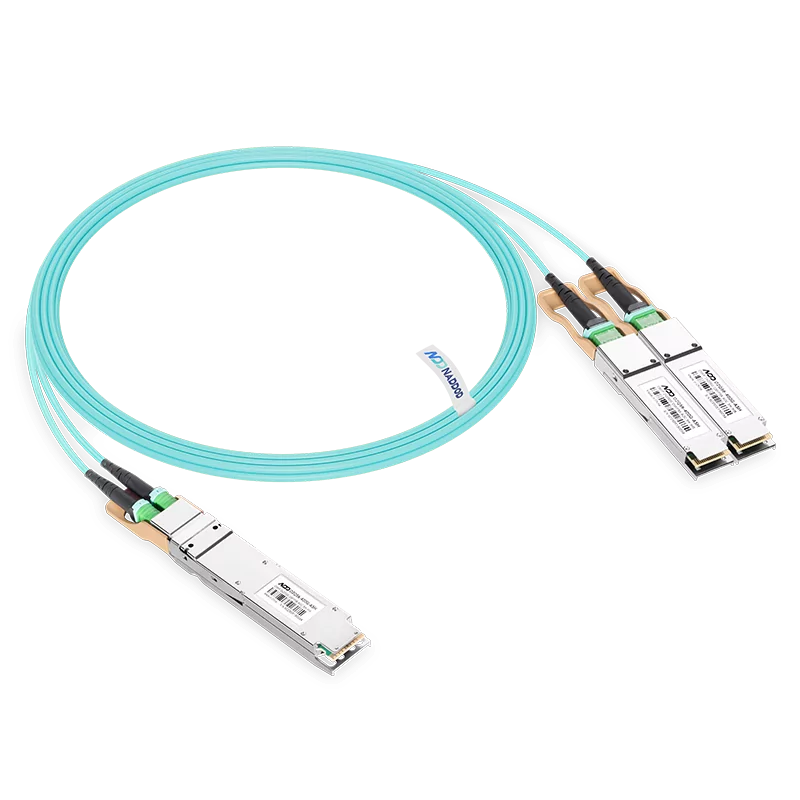
3m (10ft) NVIDIA/Mellanox MFA7U10-H003 (980-9I41X-00H003) 兼容 400G AOC OSFP IHS/Finned Top 8x50G PAM4 至 2x200G QSFP56 4x50G PAM4 InfiniBand HDR 有源光分路器电缆
US$ 928.00
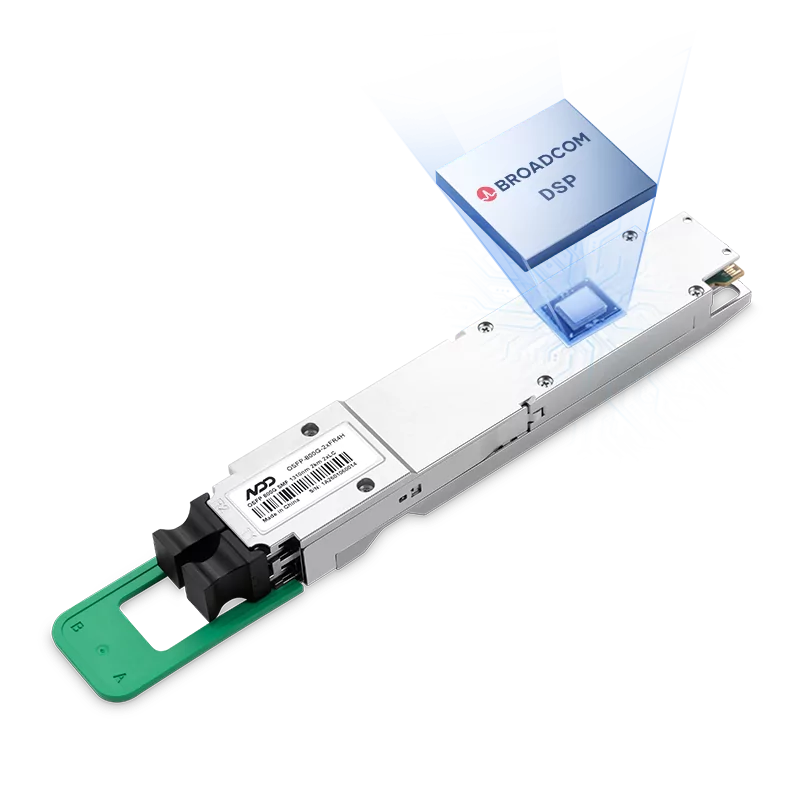
NVIDIA/Mellanox MMS4X50-NM (980-9I30L-00N000) 兼容 800G 2xFR4 OSFP IHS/Finned Top 8x100G PAM4 Broadcom DSP 1310nm 2km SMF DOM 双 LC 双工 InfiniBand NDR 光光模块模块
US$ 1,399.00
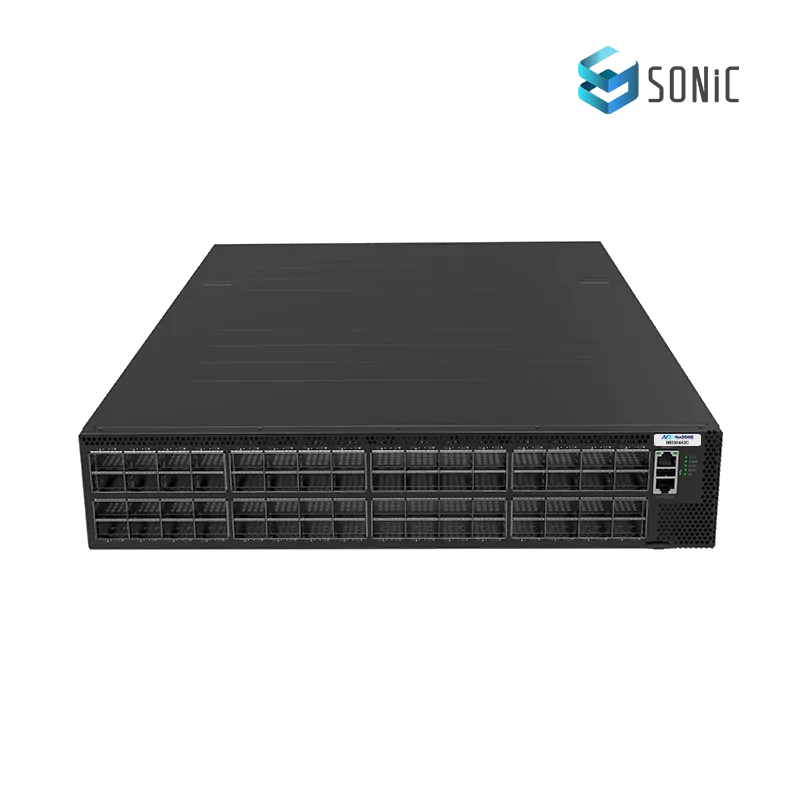
N9500-64OC、64x 800Gb OSFP、Broadcom Tomahawk 5、51.2Tbps、Dilight 企业级 SONiC,适用于 AI/ML/云/HPC
US$ 29,999.00
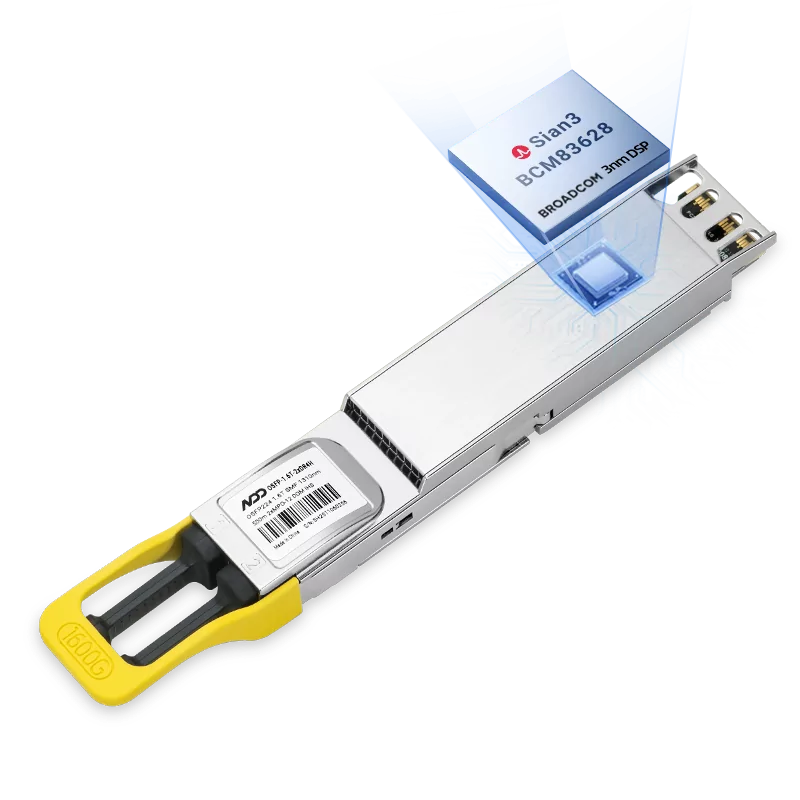
NVIDIA/Mellanox MMS4A00-XM/MMS4C10-XM/MMS4C11 (980-9IAH1-00XM00/980-9IAU0-00XM01/980-9IAU1-00XM01) 兼容 1.6T 2xDR4 OSFP224 IHS/封闭翅片顶部 8x200G PAM4 Broadcom 3nm DSP (Sian3 | BCM83628) 1310nm 500m SMF DOM 双 MPO-12/APC InfiniBand XDR 光光模块模块,适用于 Quantum-X800 风冷交换机
US$ 1,469.00
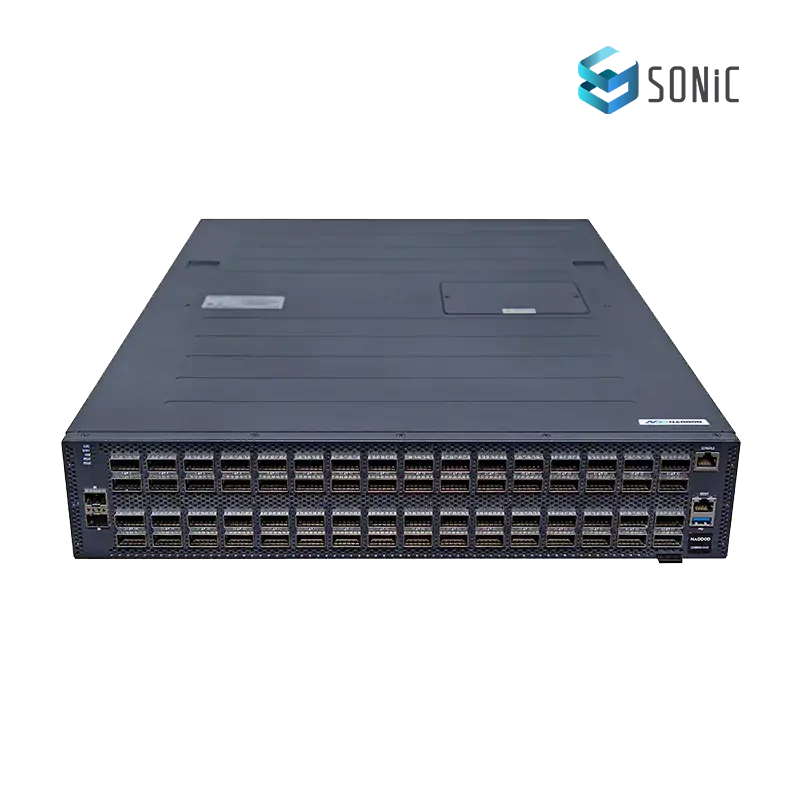
N9200-64DC、64 个 400G QSFP-DD、Broadcom Tomahawk 4、Dilight 企业 SONiC、高性能、低延迟、支持 AI 结构的 AI 数据中心交换机
US$ 18,999.00
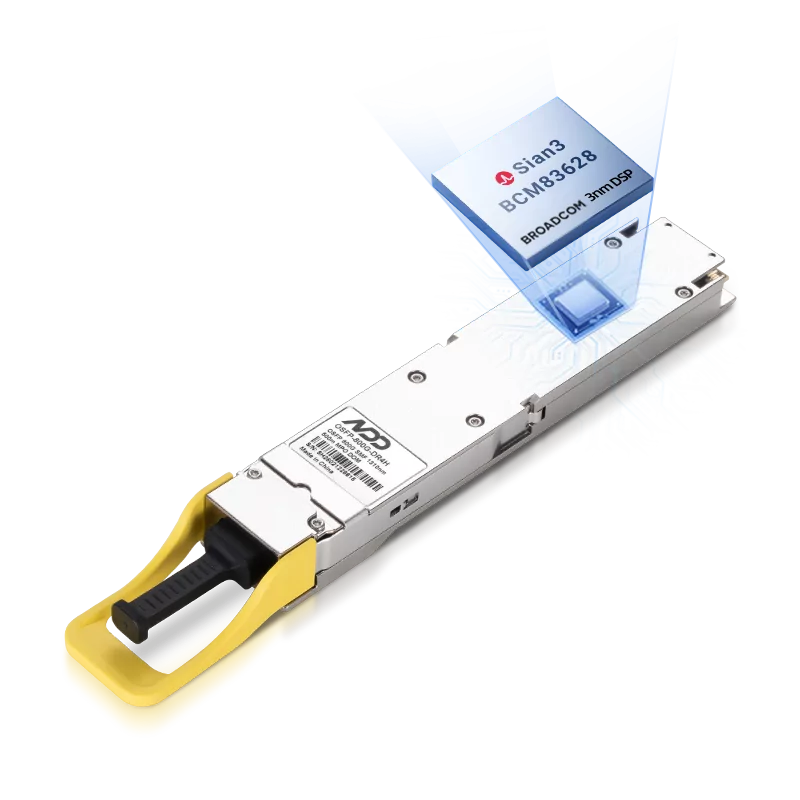
NVIDIA/Mellanox MMS4A20-XM800 (980-9IAT0-00XM00/980-9IAY0-00XM00) 兼容 800G DR4 OSFP224 RHS/平顶 4x200G PAM4 Broadcom 3nm DSP (Sian3 | BCM83628) 1310nm 500m SMF适用于 ConnectX-9/ConnectX-8/B300/GB300 的 DOM MPO-12/APC InfiniBand XDR 光光模块模块
US$ 1,099.00
寻找理想的光纤和连接解决方案来提升您的网络!