Loading content… / 正在加载内容…


As AI 随着工作负载呈指数级增长,高带宽、低延迟和节能的网络解决方案已成为现代数据中心架构的核心。 NVIDIA ConnectX-8 SuperNIC as 全球首款 800G 高速 SmartNIC,重新定义了服务器、GPU 和更广泛的网络结构的连接方式。本文将探讨ConnectX-8 SuperNIC的核心技术突破, 研究它如何成为AI工厂和AI集群网络的关键加速引擎, 并分析其对服务器架构和AI计算部署的深远影响。
1.什么是ConnectX-8 SuperNIC?
ConnectX-8 SuperNIC是NVIDIA第七代智能网卡,专为下一代AI集群、超大规模数据中心和高性能计算(HPC)场景而设计。它将网络加速与计算卸载功能深度集成,支持超高速400GbE/800GbE连接,并通过硬件级协议卸载和GPU-NIC协同优化显著降低网络延迟,同时提高吞吐量效率。为AI训练、推理、分布式存储等场景提供超低时延、无损的网络传输。
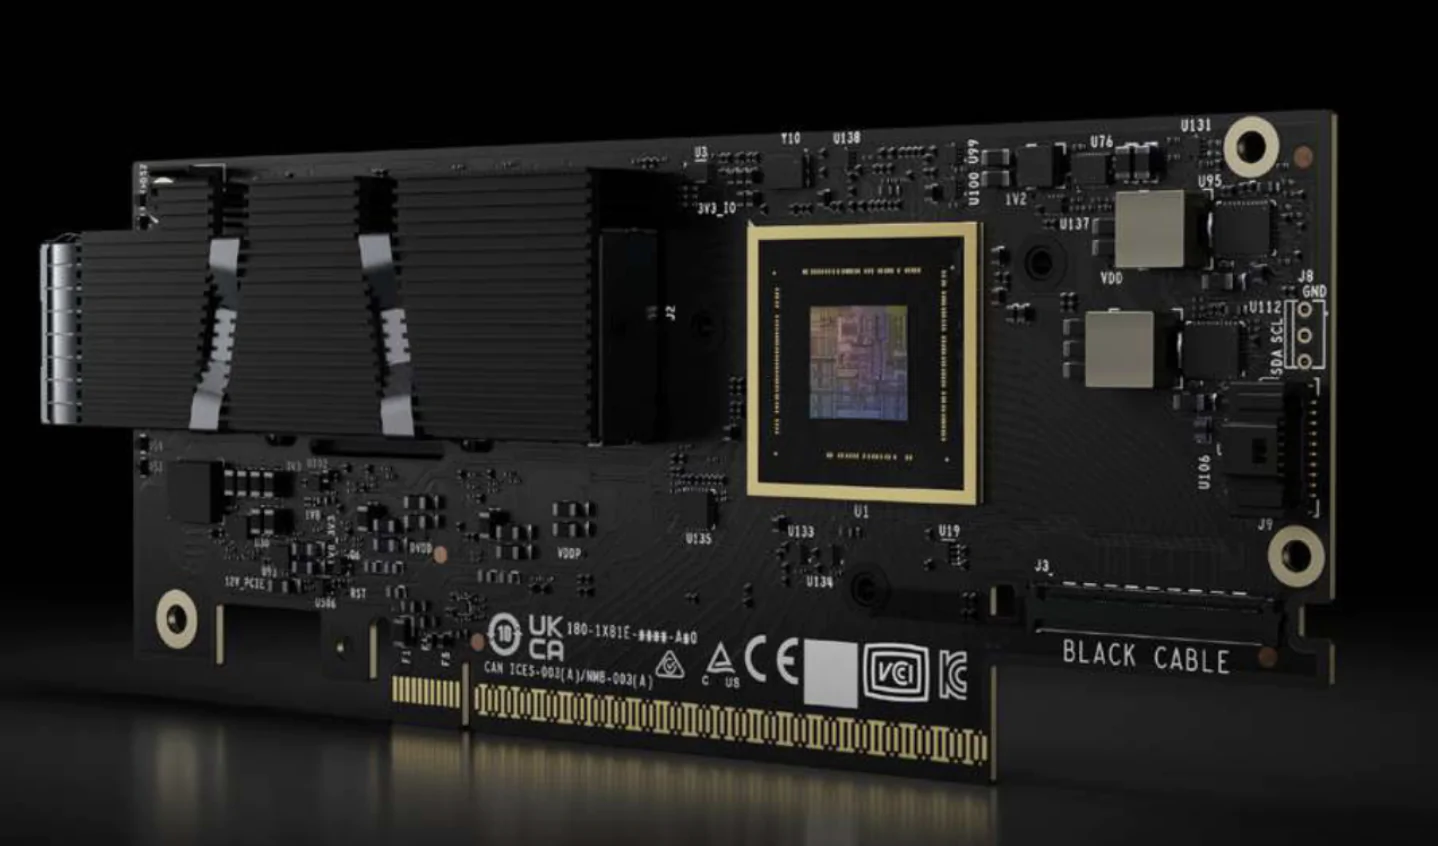
规格
- 支持的网络协议:InfiniBand、以太网
-
最大总带宽:800Gb/s
-
主机接口:PCIe Gen6 - 高达 48 通道
-
网络接口:支持单口800G OSFP112或双口400G QSF112灵活配置。向下兼容200G/100G速率,适应现有基础设施。
-
产品组合:多种硬件封装形式,适应不同服务器/主板规格。
-
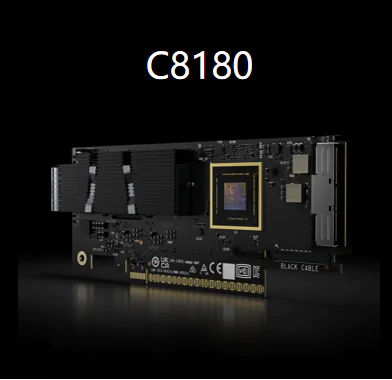
PCle HHHL 1P x OSFP:PAM4 200G/Lane,半高半长卡,带一张 OSFP端口,适合高密度机箱环境。
-
-
-
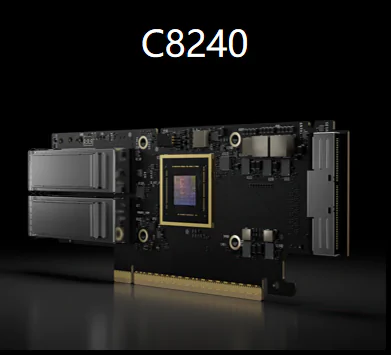
PCle HHHL 2P x QSFP112:PAM4 100G/通道,半高半长卡,带两个 QSFP112端口,适合标准机架服务器部署。
-
-
-
Dual Connect X-8 Mezzanine:PAM4 200G/Lane,双网卡模块,适用于定制服务器主板或 OCP 平台。
-
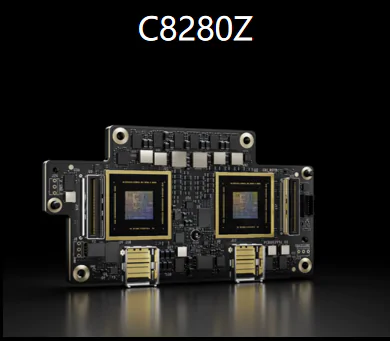
-
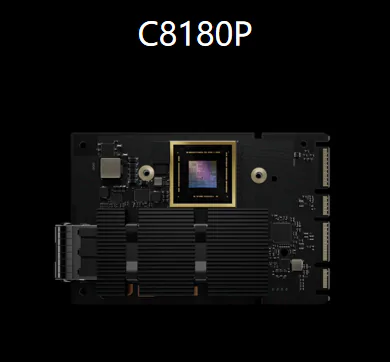
- OCP 3.0 TSFF 1P x OSFP:PAM4 200G/通道,符合 OCP 3.0 的数据中心设计,适用于下一代模块化服务器系统。
通过基于遥测的拥塞控制和智能路由,它最大限度地提高了网络和人工智能工作负载的效率。 InfiniBand版本还支持SHARP协议,使网内计算能够加速HPC场景下的分布式训练和推理。整体架构具有强大的可扩展性和未来适应性,是构建下一代人工智能基础设施的理想选择。这一系列的特性在NVIDIA发布的官方介绍中也有详细的解释, 点击这里 了解更多信息。
2.为什么ConnectX-8 SuperNIC解决方案是服务器架构的革命?
NVIDIA ConnectX-8 SuperNIC 是业界首款将 PCIe 6.0 交换机和超高速网络集成到单个设备中的 SuperNIC。它具有内置 PCIe 6.0 交换机和 48 个 PCIe 6.0 连接通道,克服了依赖分立 PCIe 交换机的传统设计的局限性。
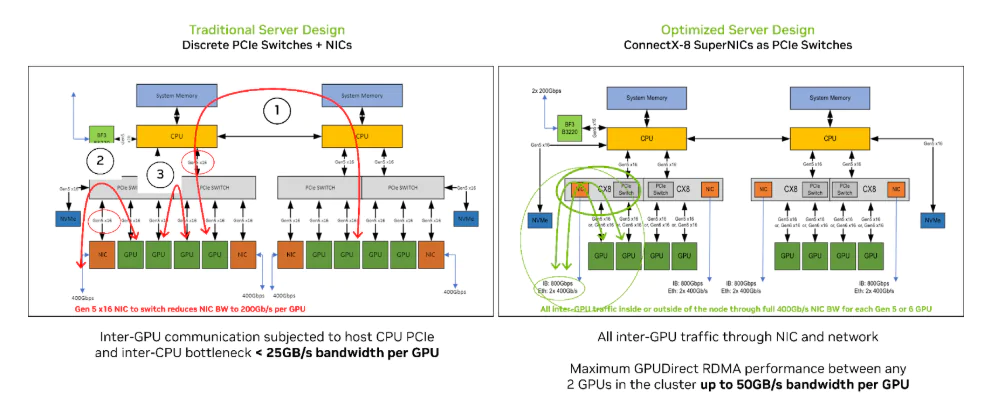
2.1 传统PCIe交换服务器设计
PCIe(Peripheral Component Interconnect Express)是当今使用最广泛的外设互连协议。它是连接高速组件的接口标准。在现代计算机系统中,显卡、存储、网卡等设备通过 PCIe 连接。它提供可靠、高效的通信速度。在PCIe架构中,PCIe Switch的功能类似于网络交换机。它连接多个 PCIe 设备,实现它们之间的数据转发,并解决通信和带宽分配问题。
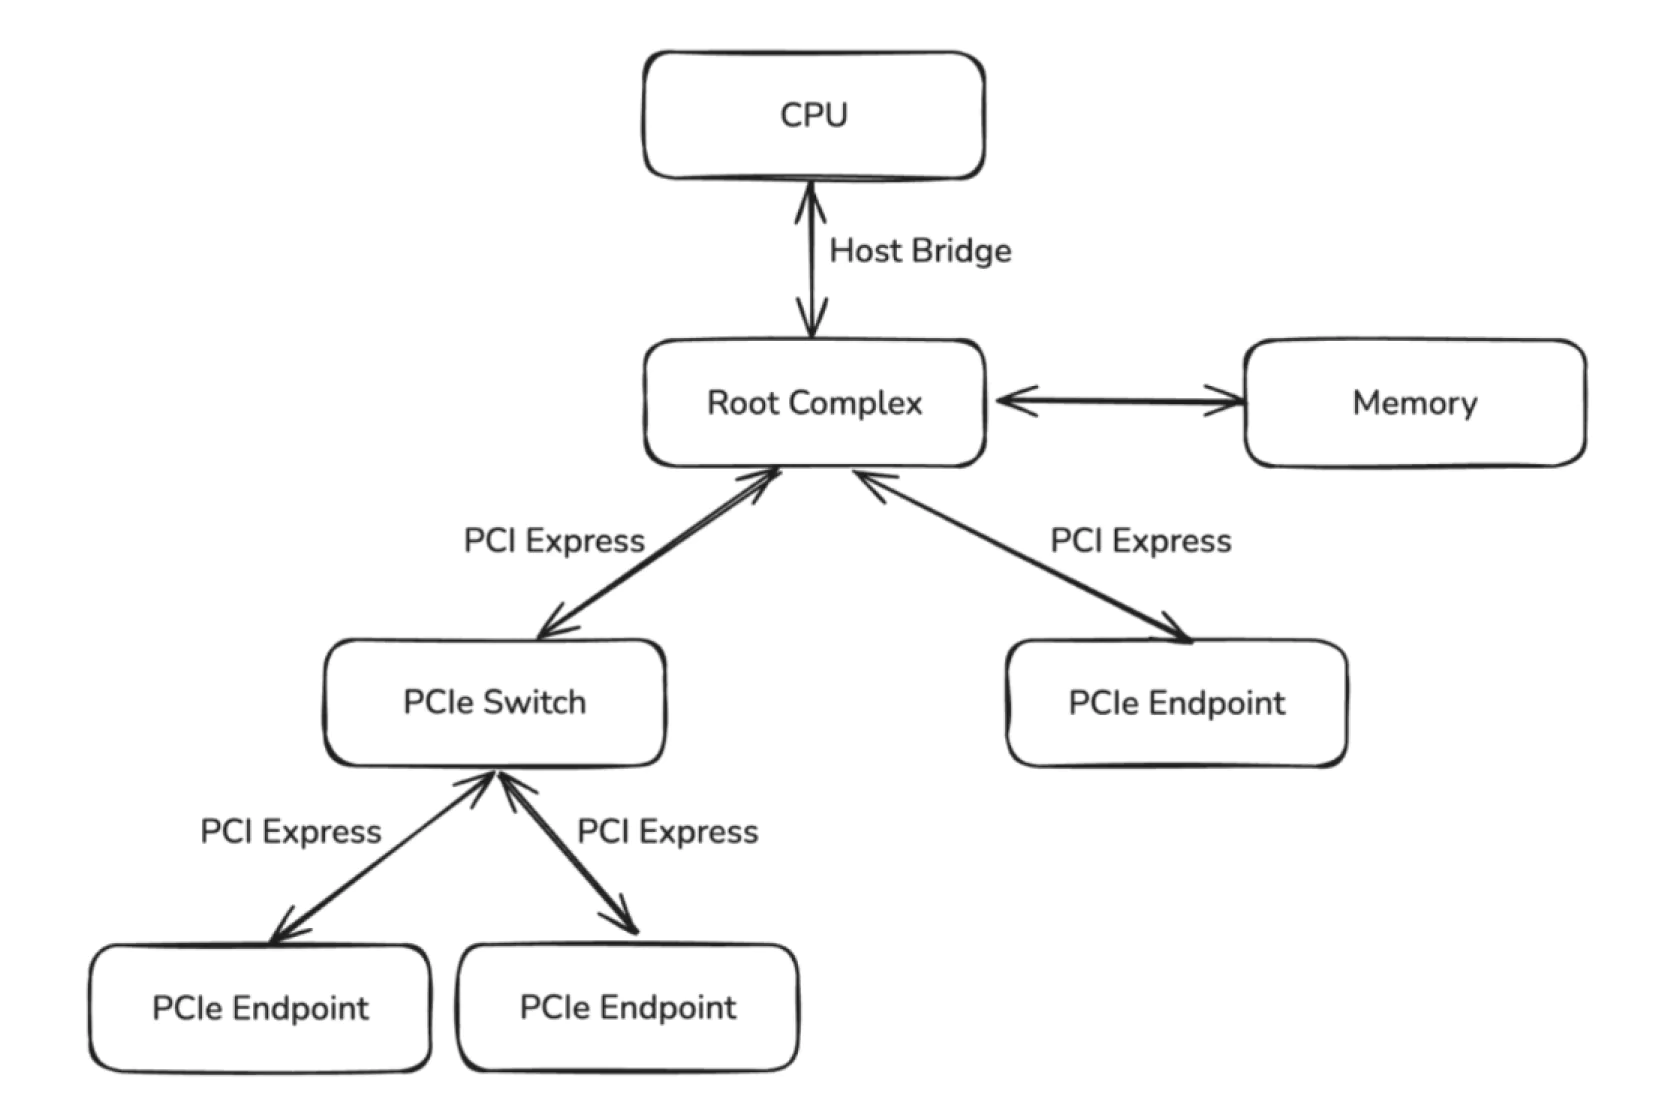
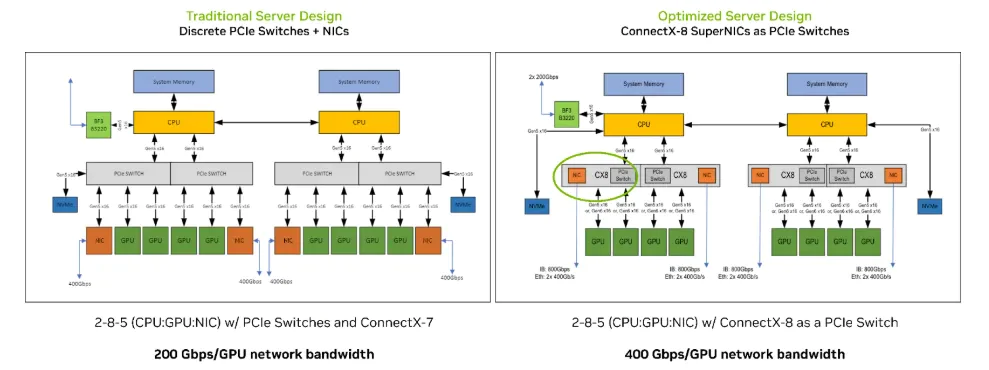
架构: 独立的PCIe交换机用于连接CPU、GPU、网卡等设备。对于具有八个 GPU 和多个 NIC 的配置,需要两到四个独立的 PCIe 交换机来实现 GPU 到 GPU 和 GPU 到 NIC 的连接。这种架构不仅增加了组件数量和整体复杂性,而且还增加了组件成本和冷却成本。
性能: GPU 到 GPU 的通信跨越两个 CPU 插槽,并且此路径可能会遇到主机 CPU 和内部插槽内的瓶颈。根据 CPU 间链接利用率,速度可能会限制为 25 GB/s 或更低。在 2:1 GPU 到 NIC 配置中,GPU 到 NIC 通信的带宽有限,并且受 PCIe 版本的影响。
2.2 基于NVIDIA ConnectX-8 SuperNIC的服务器设计
架构: NVIDIA ConnectX-8 正在重新定义基于 PCIe 的系统的可能性。通过集成可提供 48 个 PCIe 6.0 连接通道的内置 PCIe 6.0 交换机,它解决了传统独立 PCIe 交换机设计的局限性。将 GPU 到 GPU 和 GPU 到 NIC 通信整合到单个高性能设备中,无需单独的 PCIe 交换机,减少组件数量并简化主板设计,从而为 AI 基础设施创建更具成本效益和可扩展的架构。
性能: 在 NVIDIA 的优化设计中,ConnectX-8 SuperNIC 取代了专用 PCIe 交换机,将 PCIe 6.0 交换和 800 Gb/s 网络集成到单个网卡中。这使得每个 GPU 的网络带宽增加了一倍,有助于消除 IO 瓶颈并加速 GPU、NIC 和存储之间的数据移动。结果,这 NVIDIA RTX PRO 服务器平台 提供高达 2 倍的 NCCL 全面性能,加速对多 GPU 和多节点工作负载至关重要的集体通信,并提高 AI 工厂的可扩展性。
3. The Advantages of NVIDIA ConnectX-8 超级网卡
ConnectX-8 SuperNIC 网络性能改进
的 ConnectX-8 超级网卡 提供800Gb/s超高带宽,支持1个Infiniband XDR(800Gb/s) 接口或两个 400Gb/s 以太网接口。同时速度提高一倍(与上一代相比 连接X-7), 的 ConnectX-8 超级网卡 还致力于提高网络性能并优化网络效率。
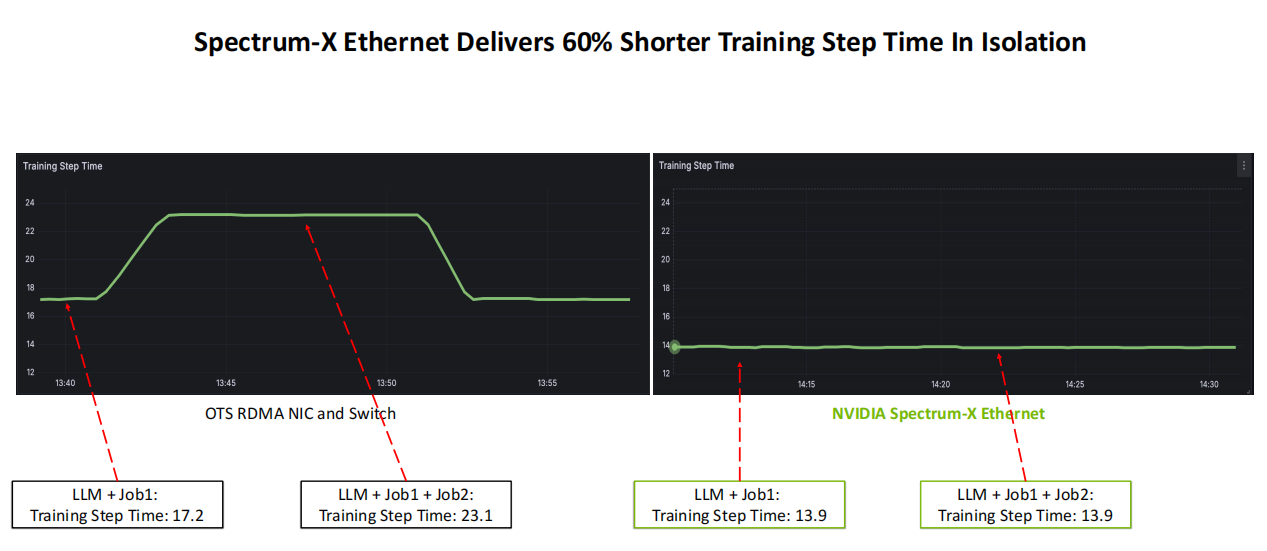
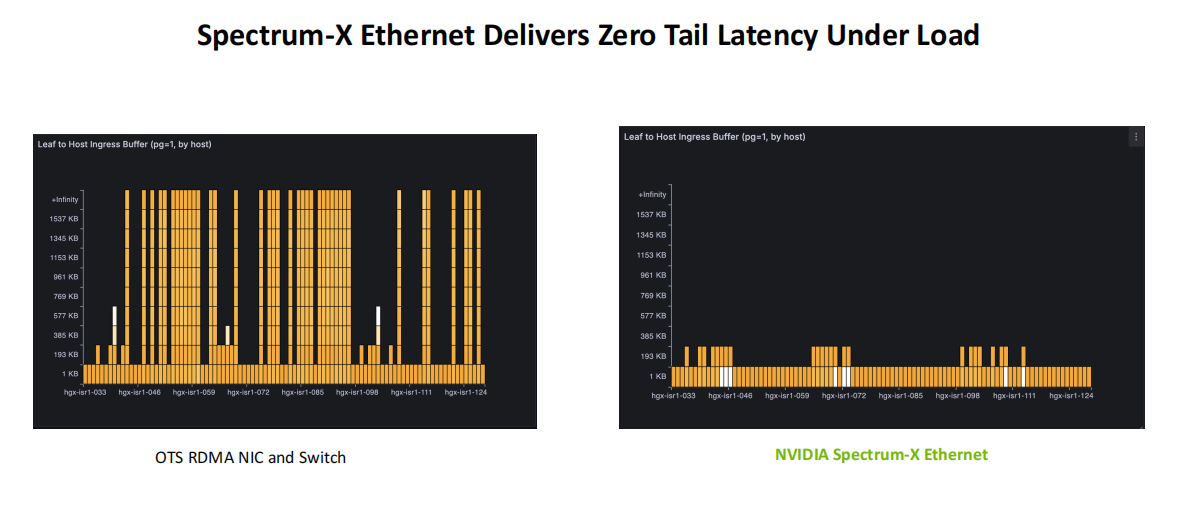
- 高稳定性与高性能: 的 ConnectX-8 超级网卡 支持线速 RDMA 数据传输,即使对于 64KB 甚至 1MB 等大消息,也可实现 800G 端到端 RDMA 数据交换。 NVIDIA 测试表明,当与 Spectrum-X 平台,AI训练步骤时间可减少60%,实现零尾延迟,整体带宽利用率提升1.6倍。
- 可编程拥塞控制和路由: 自适应路由根据当前全局状态选择数据转发的最佳路径,结合先进的拥塞控制算法来选择合适的速率。这确保了整个网络的高精度和快速收敛,这对于大规模、高带宽集群至关重要。
- GPU集群大小的64倍:的 ConnectX-8 超级网卡 与 Spectrum-X 以太网交换机深度集成,为单个 GPU 提供高达 800G (8x100G) 的带宽。利用512端口交换机(交换机基数:512),可以构建一个两层、无阻塞的胖树集群网络。此外, ConnectX-8 超级网卡 支持基于Spectrum-X以太网交换机的多平面网络,使集群能够扩展到128K GPU。相比之下,传统网卡在同等条件下只能支持大约2K的GPU。
智能化 CConnectX-8 SuperNIC 的功能
ConnectX-8 SuperNIC定位为“SuperNIC”,不仅支持800G带宽,是ConnectX-7的两倍,而且还集成了可编程加速引擎和丰富的网络功能,可以灵活卸载主机网络负载。
- 可编程嵌入式处理器: ConnectX-8 SuperNIC集成了16C RISC-V内核DPA(数据路径加速器),这使CX8具有与DPU相同的编程能力,使其能够灵活处理数据链路上的任务,以实现定制的网络卸载。例如,它可以执行数据包解析、过滤、遥测收集和其他硬件加速,以实现软件定义的网络。
- 强大的数据包处理能力: ConnectX-8 SuperNIC 具有内置 PSA 多线程数据包处理器。它可以在网卡硬件级别执行数据包检查、分类和线性转发。基于ASAP2,可以提高SDN和NFV的交换能力,将OVS、VXLAN、L4防火墙、QoS等卸载到CX8网卡上,大大降低CPU开销。
- 强大的软件生态系统: 作为一个超级 NIC ConnectX-8 SuperNIC由NVIDIA推出,提供业界领先的DPDK驱动支持,同时兼容DOCA框架,支持DOCA-PRDMA、DOCA-PCC、DOCA-FLOW等API,让开发者更容易通过软件堆栈直接利用其加速功能。
4. ConnectX-8在推动800G/1.6T光互连演进中的作用
ConnectX-8 SuperNIC采用全新的服务器设计架构,突破传统PCIe交换机的限制,支持更高带宽、更低延迟的直连。这种转变对服务器和高性能计算节点之间的数据传输能力提出了更高的要求。随着单服务器网络带宽跃升至800G,传统的400G光模块已经不足以满足日益增长的集群互连需求。这将直接带动我国的快速发展 800G和1.6T光模块.
例如,ConnectX-8优化设计使NVIDIA RTX PRO服务器能够实现800GB/s的全向带宽,将每个GPU的网络带宽翻倍至400Gb/s(基于2:1的GPU与NIC比率)。为了匹配这种性能,服务器需要800G光模块在单个端口上直接承载全速率传输,或者通过聚合两个400G端口来实现800G带宽。与此同时,交换机也面临着带宽升级的挑战。为了充分发挥服务器侧800G接口的性能,交换机需要更高容量的上行端口,这也是1.6T光模块的核心应用场景。采用1.6T光模块可实现更大规模的GPU集群互连,优化系统整体功耗和网络拓扑复杂度。
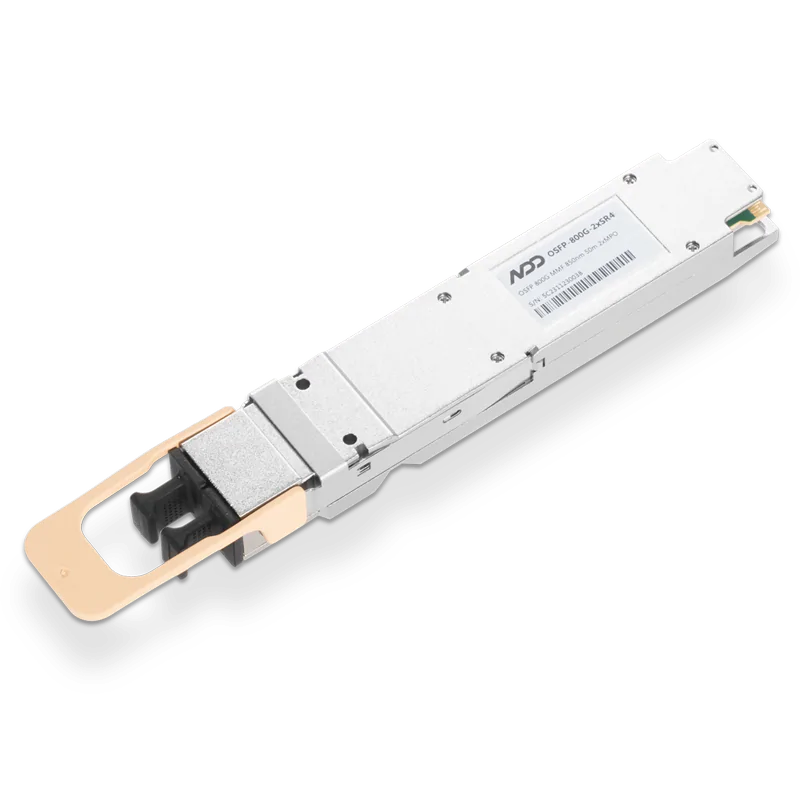
作为专注于AI网络的解决方案专家,Dilight提供全面的800G和1.6T光模块,支持以太网和InfiniBand网络。这些解决方案具有超低 BER、高可靠性和广泛的兼容性。 Dilight最新一代1.6T光模块已在全球交付和部署。 (参见Dilight 1.6T光模块测试报告: 与 Quantum-X800 交换机的兼容性; 与 NVIDIA MMS4A00 的互操作性 )目前,1.6T光模块和 1.6T DAC线 主要用于QuantumX-800交换机之间的互连以及QuantumX-800交换机与800G ConnectX-8网卡之间的连接。
无论是当前的高速GPU到NIC互连,还是下一代AI数据中心的超高带宽部署,Dilight的高性能互连解决方案都为您提供坚实的支持。随意 与 Dilight 专家联系 并探索人工智能网络的可能性。
热门文章
相关产品:
NVIDIA/Mellanox MMS4A00-XM/MMS4C10-XM/MMS4C11 (980-9IAH1-00XM00/980-9IAU0-00XM01/980-9IAU1-00XM01) 兼容 1.6T 2xDR4 OSFP224 IHS/封闭翅片顶部 8x200G PAM4 Broadcom 3nm DSP (Sian3 | BCM83628) 1310nm 500m SMF DOM 双 MPO-12/APC InfiniBand XDR 光光模块模块,适用于 Quantum-X800 风冷交换机
US$ 1,469.00
NVIDIA Quantum-X800 XDR InfiniBand 交换机,Q3400-RA,4U,144 个 XDR 端口,超过 72 个 OSFP 笼,由 Quantum-3 ASIC 供电,8 个电源(不包括电源线),标准深度,托管,C2PAirflow,导轨套件
US$ 107,099.00
NVIDIA/Mellanox MMS4A20-XM800 (980-9IAT0-00XM00/980-9IAY0-00XM00) 兼容 800G DR4 OSFP224 RHS/平顶 4x200G PAM4 Broadcom 3nm DSP (Sian3 | BCM83628) 1310nm 500m SMF适用于 ConnectX-9/ConnectX-8/B300/GB300 的 DOM MPO-12/APC InfiniBand XDR 光光模块模块
US$ 1,099.00
NVIDIA/Mellanox 兼容 ACC 3m (10ft) 双端口 2x800Gb/s OSFP224 IHS/封闭式翅片顶部至双端口 2x800Gb/s OSFP224 IHS/封闭式翅片顶部 InfiniBand XDR 有源铜缆
US$ 1,257.00
0.9m (3ft) NVIDIA/Mellanox 兼容 1.6T DAC OSFP224 IHS/封闭式翅片顶部 8x200G PAM4 至 OSFP224 IHS/封闭式翅片顶部 8x200G PAM4 InfiniBand XDR 无源直连铜缆
US$ 469.00
NVIDIA/Mellanox C8180 (900-9X81E-00EX-ST0) ConnectX-8 InfiniBand 和以太网 SuperNIC、Socket-Direct XDR 800Gb/s PAM4 200G/通道、单端口 OSFP、PCIe 6.0 x 16、高支架
US$ 1,679.00
NVIDIA/Mellanox MMS4A50-XM (980-9IAS0-00XM00) 兼容 1.6T 2xFR4 OSFP224 IHS/封闭翅片顶部 8x200G PAM4 Broadcom 3nm DSP (Sian3 | BCM83628) 1310nm 2km SMF DOM 双 LC 双工 InfiniBand XDR 光纤适用于 Quantum-X800 风冷交换机的光模块模块
US$ 2,299.00
1m (3ft) NVIDIA/Mellanox MCA7K20-X001 (980-9IAQ5-00X001) 兼容 1.6T ACC OSFP224 IHS/封闭翅片顶部 8x200G PAM4 至 4x400G OSFP224 RHS/平顶 2x200G PAM4 InfiniBand XDR 有源铜分路器电缆
US$ 2,089.00
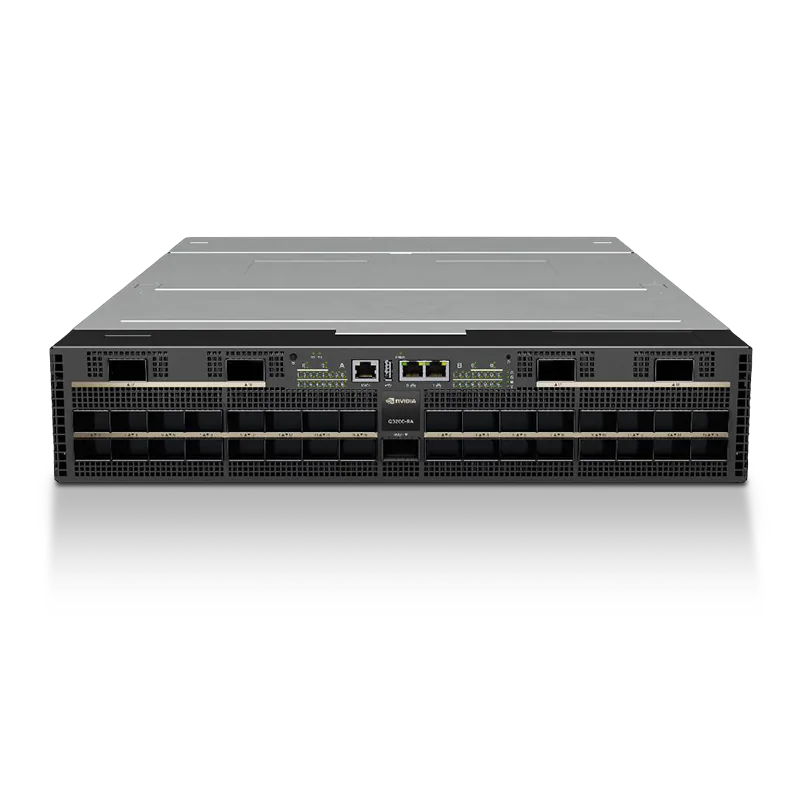
NVIDIA Q3200-RA Quantum-X800,由 Quantum-3 ASIC 供电,两个相邻的 XDR InfiniBand 交换机,2U,每个交换机 18 个 OSFP 笼上有 36 个 XDR 端口,4 个电源(不包括电源线),标准深度,托管,C2P 气流,导轨套件,提供 1 年服务
US$ 53,599.00
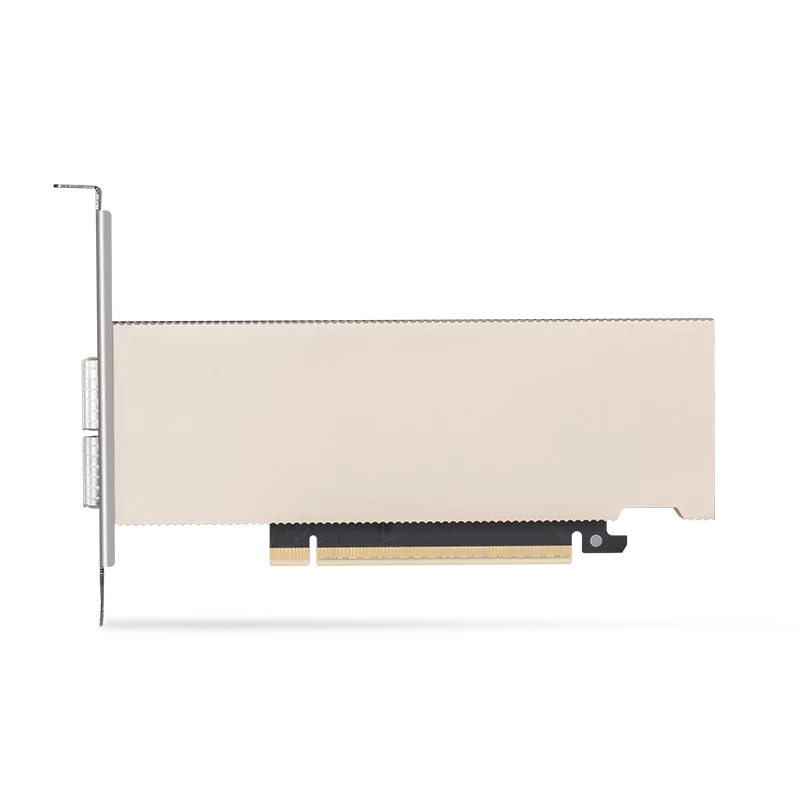
NVIDIA/Mellanox C8240 (900-9X81Q-00CN-ST0) ConnectX-8 InfiniBand 和以太网 SuperNIC、SocketDirect NDR 400Gb/s PAM4 100G/通道、双端口 QSFP112、PCIe 6.0 x 16、高支架
US$ 1,679.00
寻找理想的光纤和连接解决方案来提升您的网络!